Desde o lançamento público do ChatGPT, em 30 de novembro de 2022, praticamente toda ferramenta de martech passou a oferecer algum recurso de IA generativa — chatbot de atendimento, gerador de copy, assistente de análise de dado. Avaliar essas ferramentas com critério exige entender, mesmo que em nível básico, como um sistema desse tipo é construído. A distinção central cabe numa frase: a capacidade vem de uma etapa, o comportamento vem de outra.
Duas etapas de treinamento, dois propósitos diferentes
Um modelo de linguagem como o que sustenta o ChatGPT passa por dois estágios de treinamento distintos, com objetivos completamente diferentes:
| Estágio | O que acontece | Resultado |
|---|---|---|
| Pré-treinamento | Um transformer (arquitetura decoder-only) é treinado sobre um volume gigantesco de texto da internet, com uma tarefa simples: prever a próxima palavra de forma gramaticalmente correta e semanticamente coerente | Um modelo que completa texto de forma fluente — mas não sabe, por padrão, responder a uma pergunta como um assistente responderia |
| Fine-tuning (em três passos) | 1) Ajuste com pares de pergunta-resposta reais · 2) Treino de um “reward model” que aprende a ranquear respostas da mais à menos útil · 3) Aprendizado por reforço (PPO) usando esse reward model para tornar as respostas mais alinhadas e precisas | O modelo passa a se comportar como assistente — segue instrução, responde pergunta, recusa pedido inadequado |
A frase que vale ouro em qualquer conversa sobre IA generativa: a capacidade vem do pré-treinamento; o comportamento vem do fine-tuning. É a diferença entre conhecimento bruto e alinhamento — e é exatamente por isso que dois produtos construídos sobre o mesmo modelo-base podem se comportar de formas completamente diferentes: eles herdam a mesma capacidade subjacente, mas foram ajustados (fine-tuned) com objetivos e limites distintos.
Vídeo de apoio: How OpenAI Puts ChatGPT to Work | DevDay 2026
Vídeo publicado por OpenAI sobre How OpenAI Puts ChatGPT to Work | DevDay 2026. Material de apoio ao tema desta página.
O que isso explica na prática de avaliação de fornecedor
Essa distinção resolve uma confusão comum: por que um chatbot de atendimento ao cliente, construído “sobre GPT” ou “sobre Claude“, às vezes responde de forma genérica demais, ou às vezes recusa perguntas que deveria responder. A causa raiz quase sempre está no fine-tuning — no ajuste específico que o fornecedor aplicou (ou deixou de aplicar) sobre o modelo-base, não na capacidade fundamental do modelo em si.
Ao avaliar uma ferramenta de IA para atendimento, geração de conteúdo ou vendas, a pergunta relevante não é apenas “qual modelo vocês usam por baixo” — é “como vocês ajustaram o comportamento desse modelo para o nosso caso de uso específico, e quanto controle temos sobre esse ajuste?”. Duas ferramentas usando o mesmo modelo-base podem entregar experiências completamente diferentes dependendo da qualidade desse ajuste.
Os sete passos de uma resposta a um prompt
Quando um usuário envia uma mensagem a um sistema como o ChatGPT, o fluxo até a resposta final passa por mais etapas do que parece:
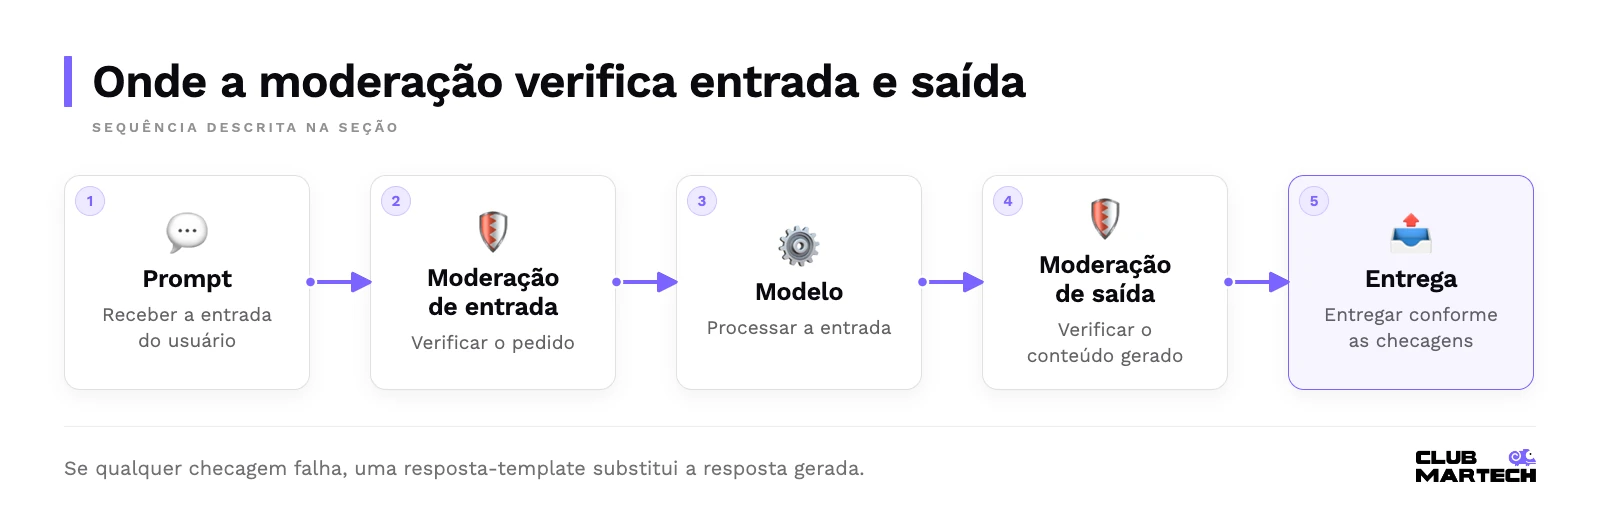
- Entrada do usuário (o prompt)
- Moderação de conteúdo sobre a entrada — verificação se o pedido viola alguma política
- Processamento pelo modelo
- Moderação de conteúdo novamente, agora sobre a saída gerada
- Resposta entregue ao usuário
Se qualquer uma das duas checagens de moderação falhar, o sistema não entrega a resposta gerada — ele substitui por uma resposta-template, genérica e segura, preparada especificamente para esses casos.
Por que a moderação precisa ser bidirecional
O ponto mais importante desse fluxo, e o menos discutido fora de círculos técnicos, é que existem dois riscos distintos, cada um exigindo sua própria camada de proteção:
- Risco de entrada — um pedido malicioso, uma tentativa de manipulação do sistema (prompt injection) ou um pedido diretamente proibido, formulado de forma explícita.
- Risco de saída — conteúdo problemático gerado a partir de uma entrada aparentemente inocente. Uma pergunta neutra pode, por caminhos inesperados na geração do modelo, levar a uma resposta inadequada, mesmo sem nenhuma intenção maliciosa visível na entrada.
Filtrar apenas a entrada é insuficiente. Um sistema que só verifica o que o usuário digitou, sem verificar o que o modelo gerou como resposta, está desprotegido contra o segundo tipo de risco — que na prática é o mais imprevisível dos dois, porque não depende de má intenção detectável na pergunta original.
A pergunta que protege sua marca
Essa distinção se traduz diretamente numa pergunta prática e específica ao avaliar ou contratar um chatbot de marca, seja para atendimento, vendas ou suporte:
“Vocês têm moderação de conteúdo na saída do modelo, não só na entrada do usuário?”
Essa pergunta separa dois tipos de produto: um bot que apenas recusa perguntas obviamente impróprias (moderação só de entrada) de um bot que ativamente evita dizer algo impróprio, mesmo quando a pergunta original era inofensiva (moderação de entrada e saída). O segundo é o que efetivamente protege a marca contra o cenário mais temido — um cliente compartilhando print de uma resposta inadequada do chatbot oficial da empresa.
O que perguntar além da moderação
A distinção pré-treino/fine-tuning e a exigência de moderação bidirecional formam a base, mas duas perguntas complementares completam uma avaliação criteriosa de fornecedor de IA conversacional:
- “O bot tem acesso à nossa documentação e base de conhecimento, ou responde só com o conhecimento geral do modelo?” — essa é a distinção entre um modelo puro e uma arquitetura com busca aumentada por recuperação (RAG), que ancora a resposta em fonte confiável em vez de depender só do que o modelo “lembra” do pré-treinamento.
- “Como vocês testam e monitoram o comportamento do bot depois de lançado?” — um fine-tuning bem feito no lançamento não garante comportamento estável para sempre; conversas reais trazem casos que o teste inicial não cobriu.
Comparativo de Modelos Fundacionais LLM para Marketing
Comparativo entre os principais motores de linguagem para integração em fluxos martech:
| Modelo / Fornecedor | Pontos Fortes (Prós) | Limitações (Contras) | Perfil Ideal de Uso | Modelo de Custo / Trade-off |
|---|---|---|---|---|
| Claude 3.5 Sonnet | Superior em raciocínio, nuances estilísticas em português, redação analítica e geração de código limpo. | Limites de taxa por minuto em janelas de alto tráfego na API. | Geração de conteúdo aprofundado, análise de relatórios e automação de agentes de marketing. | US$ 3 / 15 por milhão de tokens (input/output). |
| GPT-4o | Multimodal nativo de alta velocidade, processamento combinado de áudio, visão e texto em baixa latência. | Pode apresentar tom excessivamente genérico em redação sem engenharia de prompt refinada. | Atendimento ao cliente em tempo real, chatbots conversacionais e automações de alto volume. | US$ 2.50 / 10 por milhão de tokens. |
| Gemini 1.5 Pro | Janela de contexto massiva (até 2M tokens), integração com ecossistema Google Workspace e GCP. | Variação na precisão de JSON schemas estritos sem few-shot prompting explícito. | Auditoria de bases de dados textuais gigantescas, transcrições de vídeos longos e RAG amplo. | US$ 3.50 / 10.50 por milhão de tokens (>128k contexto). |
Critério de Decisão: Para redação, raciocínio estratégico e criação de cópias de alto impacto, o Claude 3.5 Sonnet é o modelo de referência. Para fluxos omnicanal rápidos com visão e áudio, o GPT-4o oferece a menor latência; para analisar livros, manuais ou bases inteiras de uma só vez, o Gemini 1.5 Pro é insuperável pela janela de contexto.
Por que a janela de contexto é um limite prático, não teórico
Outro conceito com implicação prática direta é a janela de contexto — a quantidade máxima de texto (medida em tokens, fragmentos de palavra) que o modelo consegue “ver” de uma vez ao gerar uma resposta, somando o histórico da conversa, as instruções de sistema e qualquer documento fornecido como referência. Quando uma conversa longa ou um documento extenso ultrapassa esse limite, o sistema precisa descartar ou resumir parte do conteúdo mais antigo — e é exatamente aí que um chatbot “esquece” o que foi dito no início de uma conversa longa, mesmo sem nenhum bug envolvido.
Para avaliação de fornecedor, isso importa especialmente em casos de uso que dependem de contexto extenso — um assistente que precisa “conhecer” todo o histórico de compra de um cliente, ou analisar um documento longo de política interna. Perguntar qual é o tamanho da janela de contexto suportada, e como o produto lida com conversas ou documentos que a ultrapassam, revela uma limitação técnica real que impacta diretamente a experiência entregue, independentemente de quão bem o fine-tuning tenha sido feito.
O erro comum: tratar todo “chatbot com IA” como equivalente
Um erro frequente na avaliação de fornecedor é assumir que, se dois produtos usam o mesmo modelo de linguagem por baixo, eles são equivalentes em qualidade e segurança. A diferença real está inteiramente na camada de fine-tuning, moderação e engenharia em torno do modelo — não no modelo em si. Um fornecedor que investiu seriamente nessa camada entrega uma experiência muito mais confiável do que outro que apenas conectou uma API de modelo genérico sem ajuste adicional, mesmo que ambos citem o mesmo nome de modelo na proposta comercial.
Por que o mesmo modelo-base varia tanto entre produtos
Uma dúvida recorrente de quem avalia múltiplas ferramentas de IA generativa é por que produtos que citam o mesmo modelo-base na ficha técnica — “construído sobre GPT-4” ou “baseado em Claude” — entregam experiências tão diferentes entre si. A resposta está inteiramente na camada que fica entre o modelo puro e o produto final: o system prompt (as instruções permanentes que moldam o comportamento antes de qualquer pergunta do usuário), a janela de contexto disponibilizada, e a qualidade do fine-tuning aplicado especificamente para aquele caso de uso.
Um fornecedor pode pegar exatamente o mesmo modelo-base que um concorrente usa e entregar um produto substancialmente melhor ou pior, dependendo de quanto investimento de engenharia foi aplicado nessa camada intermediária. É por isso que comparar ferramentas de IA apenas pelo nome do modelo citado na proposta comercial é insuficiente — o nome do modelo informa a capacidade de base, não a qualidade da experiência final entregue ao usuário.
Alucinação: o risco que a moderação sozinha não cobre
Vale distinguir moderação de conteúdo — que bloqueia respostas ofensivas, perigosas ou fora de política — de alucinação, que é o modelo gerar uma informação factualmente incorreta com total confiança aparente, sem que ela viole nenhuma política de conteúdo. Um chatbot pode passar por toda a checagem de moderação e ainda assim inventar um preço de produto, uma política de devolução inexistente, ou um dado técnico errado — porque a moderação verifica segurança do conteúdo, não sua veracidade.
Esse é o motivo pelo qual arquiteturas com RAG (retrieval-augmented generation) — que ancoram a resposta em documentos reais da empresa, em vez de depender só do conhecimento geral do modelo — são especialmente relevantes para chatbot de atendimento ou vendas: elas reduzem, ainda que não eliminem, o espaço para o modelo inventar informação sobre política interna, preço ou disponibilidade de produto. Ao avaliar um fornecedor, perguntar especificamente como ele mitiga alucinação factual — não apenas conteúdo impróprio — é uma pergunta separada e igualmente importante da pergunta sobre moderação bidirecional.
Próximos passos para avaliar seu próximo fornecedor de IA
A ação concreta: na próxima avaliação de ferramenta com IA conversacional — seja para atendimento, vendas ou geração de conteúdo —, faça as duas perguntas centrais deste artigo diretamente ao fornecedor: se existe moderação bidirecional (entrada e saída), e como o comportamento do modelo foi ajustado especificamente para o seu caso de uso. As respostas revelam, em poucos minutos, se você está avaliando um produto amadurecido ou uma API genérica com uma interface por cima.
Se a ferramenta já está em produção na sua operação, vale confirmar essas mesmas respostas retroativamente — protege a marca antes que um caso de resposta inadequada apareça em produção, em vez de depois.