A palavra zettabyte deixou de ser curiosidade de laboratório e virou sinal de alerta para times de dados, martech e tecnologia. Quando volumes crescem nessa direção, o que quebra primeiro não é o storage — quebra o modelo mental: arquitetura, governança, custo unitário e tempo de entrega entram em tensão constante.
Neste guia você vai encontrar quais plataformas fazem sentido para crescer com previsibilidade, quais padrões de código e implementação evitam retrabalho, e como priorizar otimização e eficiência sem paralisar o roadmap. O foco é operacional: decisões, trade-offs e um caminho executável.
O que muda na prática quando você opera na escala do zettabyte
Zettabyte é uma unidade gigantesca, mas o impacto real aparece antes de você chegar lá. O “efeito zettabyte” começa quando volume e variedade tornam impraticável reprocessar tudo sempre que algo muda. Nessa fase, pipelines viram produtos, e cada mudança exige compatibilidade, versionamento e observabilidade.
A primeira mudança é econômica. Em escala, o indicador que manda é custo por terabyte útil — armazenado, governado e consultável — não apenas custo bruto de armazenamento. A segunda é de performance: o gargalo passa a ser I/O, metadados, pequenas leituras repetidas e concorrência, mais do que CPU.
Quando tratar zettabyte como meta arquitetural: aplique essa lente se você já vive pelo menos dois destes sintomas:
- Reprocessamento total leva horas ou dias
- Seu catálogo de dados não acompanha mudanças de esquema
- Custos crescem mais rápido que receita
- Compliance exige rastreabilidade ponta a ponta
No contexto de martech e analytics, isso aparece como explosão de eventos, sinais de mídia, logs, dados de produto e integrações. Ferramentas que funcionavam bem com lotes diários começam a falhar com near real-time. A saída é desenhar para incrementalidade, isolamento por domínio e contratos de dados.
Métrica para acompanhar: reduza o tempo médio para colocar um novo dado em produção (lead time) e monitore o crescimento de consultas por usuário. Se o lead time sobe enquanto o uso cresce, sua arquitetura está perdendo elasticidade.
Lakehouse, warehouse ou streaming: como escolher sem apostar no escuro
Em vez de buscar “a plataforma perfeita”, escolha um conjunto coerente para três trabalhos: armazenamento governado, processamento elástico e serving para consumo. Na prática, o padrão mais frequente é o lakehouse com formatos abertos e múltiplos motores de consulta.
Warehouse é a escolha certa quando:
- O consumo é majoritariamente BI e modelagem relacional
- A equipe é enxuta e precisa de governança forte com menos overhead operacional
- Exemplos: Snowflake e Google BigQuery
Lakehouse é a escolha certa quando:
- Você precisa de flexibilidade para dados semi-estruturados, ML e múltiplos engines
- Quer custos mais controláveis com storage separado do compute
- Exemplos: Databricks com Apache Iceberg ou Delta Lake
Streaming é obrigatório quando:
- Decisões de negócio dependem de eventos em minutos ou segundos: detecção de fraude, personalização em tempo real, alertas operacionais, atribuição baseada em eventos
- Para backbone de eventos: Apache Kafka
- Para processamento contínuo: Apache Flink
Checklist de seleção:
- Defina o SLO do dado: latência aceitável, frescor e disponibilidade por domínio
- Meça concorrência real: quantos usuários e sistemas consultam simultaneamente
- Exija formatos abertos para reduzir lock-in (Parquet + tabela transacional)
- Separe dados quentes, mornos e frios com políticas explícitas
- Priorize integração com catálogo e controle de acesso no nível de tabela e coluna
Decisão rápida: se você precisa de múltiplos tipos de consumo (BI, notebooks, APIs e ML) e quer reduzir reescritas, lakehouse tende a ganhar. Se o foco é SQL governado e simplicidade operacional, warehouse tende a ganhar.
Arquitetura de ingestão e processamento: do edge ao streaming contínuo com governança desde o início
Em escala rumo ao zettabyte, ingestão é menos sobre “capturar tudo” e mais sobre “capturar com contrato”. O pipeline precisa aceitar evolução de esquema, suportar reprocessamento seletivo e manter linhagem de dados. Para isso, desenhe um fluxo com camadas e responsabilidades claras.
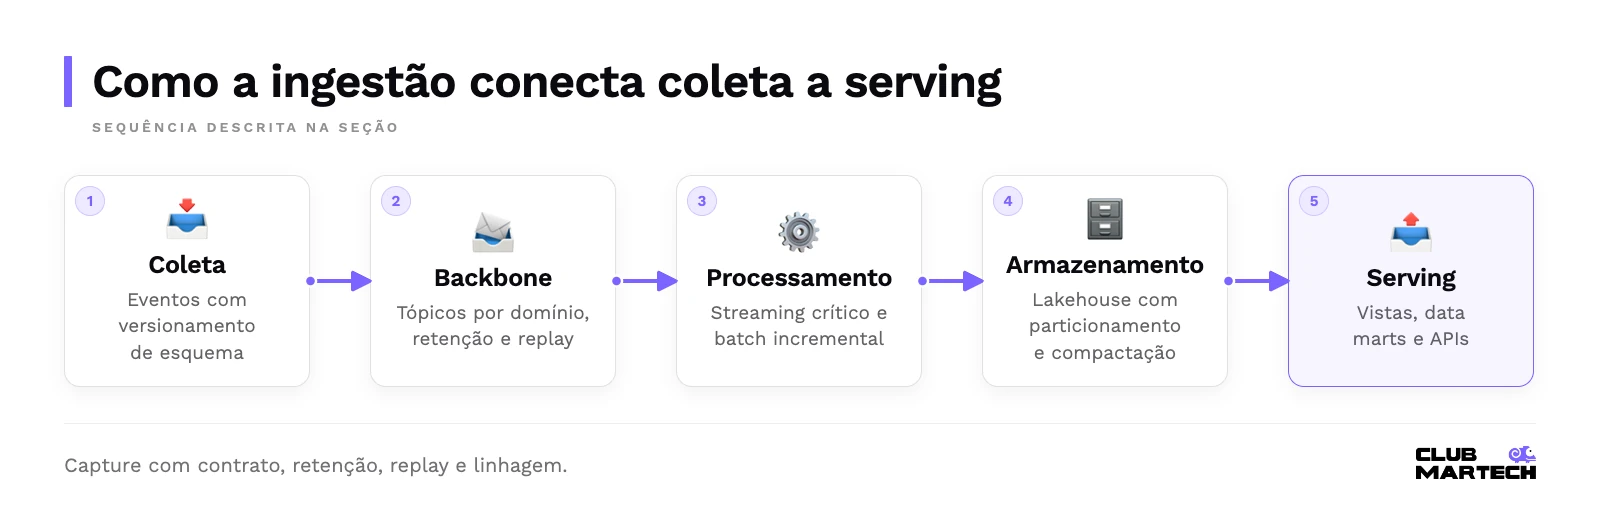
Workflow recomendado:
- Coleta — SDKs, CDC e conectores publicam eventos com versionamento de esquema
- Backbone de eventos — tópicos por domínio, com retenção e replay habilitados
- Processamento — streaming para sinais críticos, batch incremental para consolidação
- Armazenamento — tabela transacional no lakehouse, particionada e compactada
- Serving — vistas materializadas, data marts e APIs para produtos de dados
No backbone, Kafka cumpre o papel de buffer e desacoplamento. No processamento, você pode combinar Flink para baixa latência e Apache Spark para cargas pesadas e transformações complexas. O ponto é evitar uma única fila monolítica que mistura domínios distintos.
Regra de decisão por latência:
| Janela de valor do evento | Abordagem recomendada |
|---|---|
| Menos de 15 minutos | Streaming end-to-end |
| Até 24 horas | Batch incremental |
| Indefinida | Você ainda não definiu o SLO |
Métricas operacionais que evitam surpresas:
- Consumer lag por tópico no Kafka
- Time-to-analytics: tempo até disponibilidade analítica
- Percentual de eventos inválidos por versão de esquema
- Custo por milhão de eventos processados
Particionamento, formatos, catálogo e qualidade: padrões de código que escalam
A diferença entre uma plataforma cara e uma eficiente costuma estar em decisões pequenas, repetidas e padronizadas. Em zettabyte, elas viram multiplicadores. O núcleo técnico é: formato colunar, tabelas transacionais, particionamento inteligente, catálogo forte e testes automatizados.
Formatos e tabelas: use Apache Parquet como base colunar com uma camada de tabela que suporte ACID e evolução de esquema — Iceberg ou Delta Lake. Isso evita pastas caóticas e “partições fantasma”.
Particionamento (regra prática): particione por dimensões com cardinalidade moderada e alto uso em filtros, como data e região. Evite particionar por user_id ou event_id. Para filtros em campos de alta cardinalidade, use clustering e ordenação física em vez de criar milhares de partições.
Exemplo de implementação incremental com PySpark:
from pyspark.sql import functions as F

raw = spark.read.json("/landing/events/date=2026-01-04")
clean = (raw
    .withColumn("event_date", F.to_date("timestamp"))
    .withColumn("schema_version", F.col("schema_version").cast("int"))
    .filter("event_name is not null")
)

(clean
    .repartition("event_date")
    .write
    .format("delta")
    .mode("append")
    .partitionBy("event_date")
    .save("/lakehouse/events")
)
Catálogo e governança: sem catálogo, ninguém confia nos dados. Considere soluções com APIs e linhagem, como Apache DataHub ou OpenMetadata. Para transformação padronizada e auditabilidade, dbt acelera entregas em SQL com versionamento nativo.
Qualidade como contrato: automatize checagens em cada carga. Ferramentas como Great Expectations permitem definir expectativas por coluna e falhar cedo — o custo de correção explode em escala, então detectar na ingestão é sempre mais barato.
Como reduzir custo por TB e acelerar consultas sem comprometer governança
Em escala, otimização não é um projeto pontual — é uma rotina com metas e limites. Você precisa de três alavancas: reduzir dados inúteis, reduzir leituras desnecessárias e ajustar compute ao padrão real de uso.
Métrica central: custo por terabyte consultado por domínio. Ela obriga times a discutir valor, não apenas volume. Um bom objetivo é reduzir esse custo trimestre a trimestre mantendo o SLO de latência.
Melhorias com maior impacto (ordem recomendada):
- Compactação e file sizes — muitos arquivos pequenos destroem performance e sobrecarregam metadados; aplique jobs de compaction regulares
- Pruning e estatísticas — habilite stats e organização física para reduzir scans desnecessários
- Materialização — materialize as agregações que aparecem em 80% das análises
- Separação de workloads — isole BI, ELT e data science para evitar concorrência destrutiva
Para motores SQL distribuídos em lakehouse, Trino é usado frequentemente para federar fontes e acelerar consultas ad hoc. Para fechar o ciclo FinOps, use as ferramentas nativas de cada cloud: AWS Cost Explorer, Google Cloud Billing e Azure Cost Management.
Regra de corte de custo sem dor: se um conjunto de dados não tem consumo comprovado em 90 dias, degrade para camada fria com retenção definida. Se o time não consegue provar uso, o time não controla a plataforma.
Exemplo de ganho realista: reduzir tempo médio de consulta de 45s para 8s ao (1) compactar arquivos, (2) reorganizar por data e dimensão de negócio, e (3) materializar as três métricas mais usadas. A partir daí, adoção cresce e custo por insight cai.
Governança, segurança e observabilidade: a sala de controle que evita incidentes
Quando dados viram infraestrutura crítica, governança precisa ser tão operacional quanto deploy. A aplicação prática é uma sala de controle com painéis de custo, performance e risco em tempo real — você enxerga tempestades antes de bater nelas.
Segurança (mínimo viável que escala):
- IAM por função e serviço, não por usuário humano
- Controle de acesso por tabela, coluna e linha quando necessário
- Criptografia em repouso e em trânsito com rotação de chaves
- Segregação por domínio e por ambiente (dev, stage, prod)
Em ambientes AWS, AWS Lake Formation governa permissões no data lake. Em stacks Databricks, Unity Catalog oferece governança unificada entre workspaces.
Observabilidade: padronize logs, métricas e traces com OpenTelemetry. Para métricas e dashboards, a combinação Prometheus + Grafana é referência de mercado e funciona bem com stacks de dados modernas.
Checklist de operação semanal:
- Top 10 tabelas por custo e por tempo de consulta
- Backlog de compaction e jobs atrasados
- Erros por versão de esquema e por produtor
- Acessos fora do padrão (anomalias de permissão)
- Dados prestes a estourar SLA de retenção
Regra de ouro: se um domínio não tem owner, SLO e dashboard, ele não está em produção — está em risco.
Comparativo de Plataformas para Processamento de Dados em Hiperescala
Tecnologias para engenharia e análise de dados em volumes massivos (Petabytes a Zettabytes):
| Plataforma / Tecnologia | Capacidade de Escala | Desacoplamento Storage/Compute | Aplicações Típicas | Formato de Custo |
|---|---|---|---|---|
| Snowflake | Escala automática virtual de computação sob demanda sem interrupção de serviço. | Separação total entre armazenamento e nós de computação; excelente governança e compartilhamento seguro de dados. | Lakes analíticos, data warehouses corporativos e monetização de dados com segurança. | Consumo de créditos por segundo de computação ativa. |
| Databricks | Pioneira na arquitetura Lakehouse com Apache Spark nativo e Delta Lake. | Capacidade inigualável para engenharia de dados em lote, streaming em tempo real e pipelines de machine learning. | Pipelines massivos de IA, processamento de sinais de IoT e telemetria de grande porte. | Cobrança baseada em DBU (Databricks Units) sobre nuvem AWS/Azure/GCP. |
| Apache Iceberg | Formato de tabela aberto e de alta performance para grandes conjuntos de dados analíticos. | Permite que diferentes motores (Trino, Spark, Flink, Snowflake) consultem os mesmos arquivos Parquet sem duplicação. | Camada de armazenamento aberta para evitar qualquer forma de vendor lock-in corporativo. | 100% open-source e gratuito sob a Apache Software Foundation. |
| ClickHouse | Processamento vetorial analítico com taxa de compressão extrema de dados brutos. | Executa bilhões de agregações por segundo em clusters horizontais de hardware padrão. | Logs de rede, telemetria de publicidade digital, eventos de fraudes e streaming de métricas. | Software livre ou ClickHouse Cloud gerenciado. |
Critério de Decisão: Para unificar engenharia pesada de dados, machine learning e lakehouse, a Databricks lidera a arquitetura. Se o objetivo for um data warehouse empresarial pronto para consumo de negócios com governança impecável, o Snowflake é a solução de referência.
Próximos passos para operar dados em escala com previsibilidade
Operar dados pensando em zettabyte não é sobre chegar a um número específico. É sobre criar uma plataforma que continue previsível quando volume, variedade e velocidade dobram. A execução começa com escolhas conscientes de plataformas, segue com padrões consistentes de código e implementação, e se sustenta com rotinas de otimização e eficiência.
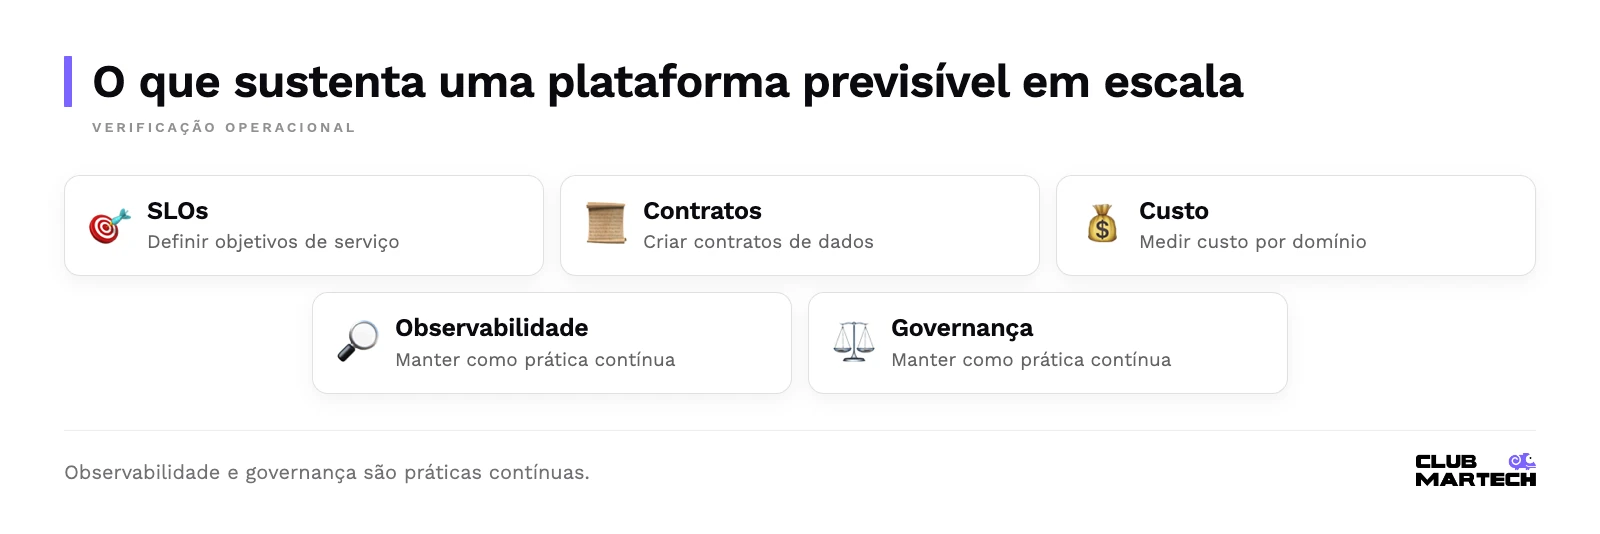
Defina SLOs, crie contratos de dados, meça custo por domínio e mantenha observabilidade e governança como práticas contínuas. Feito isso, a escala deixa de ser ameaça e vira vantagem competitiva: mais sinais, decisões mais rápidas e menos surpresas em produção.