
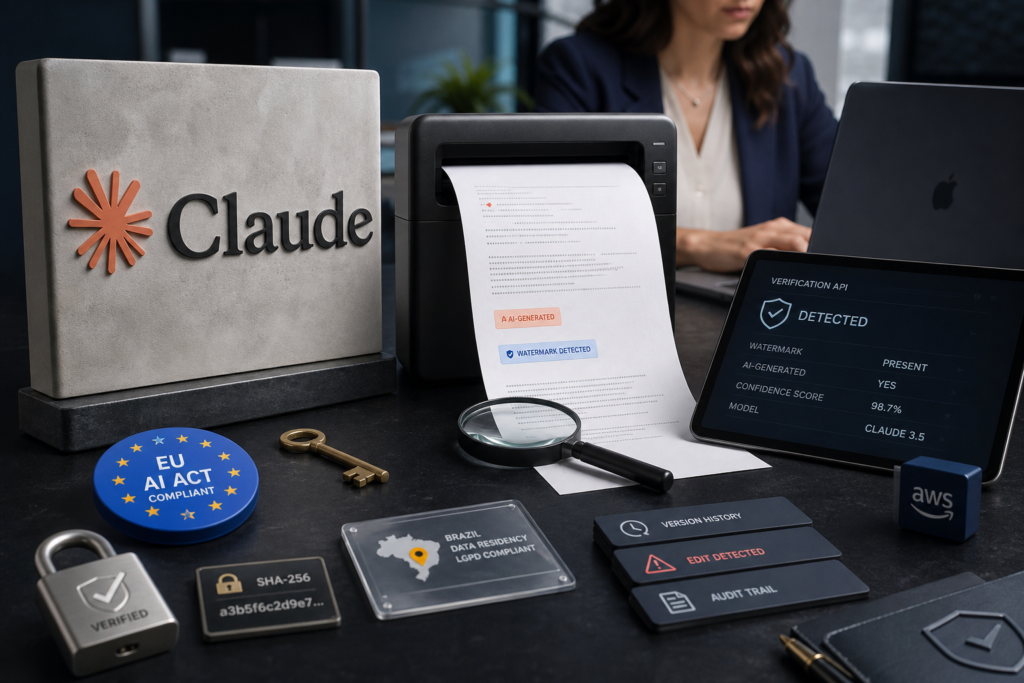
Quem produz, revisa ou aprova conteúdo poderá ganhar uma nova camada de verificação, mas ela não funcionará como um detector universal. Em 18 de agosto de 2026, a Anthropic explicou que pretende marcar textos de inteligência artificial (IA) criados pelo Claude com um padrão invisível. Para equipes brasileiras, o ponto imediato é entender a limitação: a fonte não informa quando a tecnologia ou sua ferramenta de consulta estarão disponíveis no Brasil.
O que este capítulo muda na corrida dos modelos?
A Anthropic está desenvolvendo sua solução com base no SynthID-Text, tecnologia do Google DeepMind que interfere na escolha estatística das palavras durante a geração. O movimento acrescenta rastreabilidade à disputa entre modelos de IA, até aqui concentrada em capacidade, custo, velocidade e integração.
O capítulo anterior dessa iniciativa específica não aparece no material fornecido. O fato novo, detalhado em 18 de agosto de 2026, é a confirmação do mecanismo e de uma futura forma de consulta por terceiros.
Isso importa porque a gente deixa de discutir apenas se um texto parece artificial. A proposta passa a buscar sinais inseridos pelo próprio sistema que o gerou, embora esses sinais continuem probabilísticos e frágeis diante de alterações.
Como a marca invisível será inserida?
Um modelo de linguagem escolhe cada palavra considerando o contexto anterior e as alternativas estatisticamente plausíveis. Quando existem opções equivalentes, uma chave criptográfica orienta determinadas escolhas e forma uma sequência reconhecível pelo detector.
Segundo a explicação publicada pelo Tecnoblog, a Anthropic afirma que o padrão não deve prejudicar a qualidade do conteúdo. A empresa relaciona essa avaliação a testes internos e aos resultados do estudo do SynthID-Text, mas o material não apresenta métricas desses testes.
A verificação será oferecida por uma API, ou Interface de Programação de Aplicações, para plataformas, instituições e desenvolvedores. A data de lançamento, as condições comerciais e o alcance geográfico ainda não foram informados na fonte.
Por que a exigência europeia importa para o Brasil?
O desenvolvimento acompanha a Lei de Inteligência Artificial da União Europeia, cujo regulamento, conforme a fonte, começou a valer em 2 de agosto. A regra determina a adoção de meios para tornar detectável conteúdo produzido por ferramentas de inteligência artificial (IA).
Essa obrigação europeia não vale automaticamente para operações brasileiras, e também não há, no material, regra nacional equivalente ou anúncio local da Anthropic. O marco legal da inteligência artificial ainda não é lei: o PL 2338/2023 foi aprovado pelo Senado em dezembro de 2024 e segue na Câmara dos Deputados, aguardando parecer do relator na Comissão Especial. Ainda assim, produtos globais podem carregar o mesmo recurso para diferentes mercados, então a gente precisa acompanhar como acesso, documentação e políticas chegarão por aqui.
Para times que já cuidam de governança de dados e LGPD, a lição é separar obrigação legal, política interna e capacidade técnica, pois são camadas relacionadas, mas não intercambiáveis.
Onde a detecção pode falhar?
A marca não transforma o Claude em árbitro definitivo de autoria, porque edições simples podem reduzir o sinal e uma reestruturação completa tende a removê-lo.
Na prática, você deve tratar o resultado como evidência complementar, especialmente nestes casos citados pela Anthropic:
- Trechos muito curtos, que oferecem pouca sequência para análise.
- Respostas apoiadas em fatos exatos ou operações matemáticas, que deixam menos espaço para escolhas alternativas.
- Código de programação, cuja seleção de termos costuma ser mais restrita do que na escrita corrente.
- Texto originalmente humano que passou apenas por uma revisão feita pelo assistente.
Para a rotina de um copywriter que trabalha com ferramentas digitais, isso impede conclusões automáticas sobre autoria, fraude ou desempenho profissional.
E agora?
O próximo capítulo provável é a publicação da API e de critérios operacionais, como acesso, cobertura de idiomas, precisão e tratamento de falsos resultados, mas isso é leitura de cenário, não uma previsão de prazo.
No momento, vale mapear onde sua operação registra uso de IA, quem revisa o conteúdo e quais decisões nunca devem depender apenas do detector. Transparência de processo continua sendo mais controlável do que tentar reconstruir a autoria depois da publicação.
Consulte o artigo na íntegra no link: https://tecnoblog.net/noticias/anthropic-explica-como-o-claude-vai-identificar-textos-gerados-por-ia/