Um encaixe de madeira pode parecer alinhado de cima e revelar uma falha quando visto de lado. Para avaliar o próprio trabalho, você precisa de critérios que permitam enxergar esse outro ângulo. O efeito Dunning-Kruger trata de uma relação estudada entre desempenho e autoavaliação, mas sua interpretação exige mais cuidado do que a curva popular de confiança sugere.
O que é o efeito Dunning-Kruger
O efeito Dunning-Kruger, em inglês Dunning–Kruger effect, recebeu o nome de Justin Kruger e David Dunning. No estudo de 1999, com quatro experimentos sobre humor, gramática e lógica, eles relataram que participantes do quartil inferior tinham desempenho em torno do percentil 12, mas se estimavam perto do percentil 62. Os autores propuseram que dificuldades para reconhecer erros poderiam contribuir para essas avaliações infladas.
A classificação nesta biblioteca é Efeito. O conceito não permite medir inteligência a partir de uma conversa nem concluir que toda pessoa confiante sabe pouco. Desempenho precisa ser definido em uma tarefa, e confiança precisa ser medida de modo comparável. Um rótulo aplicado a um colega não atende a essas condições.
Como funciona a hipótese e onde está o debate
A explicação metacognitiva considera que habilidades necessárias para executar uma tarefa também podem ajudar a reconhecer sua qualidade. Se alguém não identifica um erro de análise, pode não perceber que precisa rever sua avaliação. Essa é uma hipótese examinável; não descreve automaticamente toda situação de excesso de confiança.
Também existem questões estatísticas. Quando desempenho tem ruído e pessoas são separadas em grupos a partir desse desempenho, padrões de autoavaliação podem refletir regressão à média e o efeito melhor-que-a-média, a tendência geral de se avaliar acima da média. Gignac e Zajenkowski, em 2020, argumentaram que o gráfico por quartis é confundido por esses fatores. Com 929 adultos que estimaram a própria inteligência e fizeram um teste de raciocínio, métodos estatísticos alternativos não encontraram o padrão previsto. Os autores concluíram que o fenômeno pode ser plausível para algumas habilidades, mas com magnitude bem menor do que a relatada antes.
Essa crítica não encerra a literatura. Antes dela, Ehrlinger e colaboradores (2008) testaram explicações alternativas, como erro de medida e falta de incentivo, e relataram que participantes de baixo desempenho continuavam superestimando seus resultados. Depois dela, uma replicação publicada em 2023 encontrou um efeito estatisticamente significativo, mas de magnitude mínima. Para interpretar uma pesquisa, examine como desempenho e confiança foram medidos, como os grupos foram construídos e qual explicação os dados conseguem distinguir.
Exemplo cotidiano
Em um cenário hipotético, uma pessoa aprende a montar uma prateleira e julga o trabalho concluído porque ela parece reta. Um exame com critérios de fixação e carga revela falhas que a pessoa ainda não conhecia. Esse episódio ilustra a utilidade de avaliação externa, sem comprovar individualmente o efeito Dunning-Kruger.
Uma checagem responsável é definir o que um trabalho adequado exige e comparar execução com esse critério. Depois do feedback, a pessoa pode rever tanto o produto quanto a própria estimativa. O aprendizado deve preservar a oportunidade de melhorar; usar o nome do efeito como insulto não esclarece a falha de execução.
Dois exemplos em martech
Métrica e análise de campanha
Imagine um profissional que domina a interface de uma ferramenta e declara alta confiança em um relatório de retorno. Ao revisar a análise, a equipe encontra custos ausentes e duplicação de eventos. A decisão distorcida seria aceitar a confiança expressa como prova de validade do cálculo.
Peça a reconstrução da métrica com definição, fontes e testes de consistência. Registre a confiança em uma previsão concreta antes de conhecer o resultado e compare-a com a evidência posterior. A revisão pode revelar um erro de conhecimento, de implementação ou de comunicação. Nenhuma dessas possibilidades deve ser reduzida a um diagnóstico pessoal.
Pesquisa e avaliação de UX
Em outro exemplo hipotético, uma equipe considera uma página fácil de usar porque conhece cada etapa de sua construção. Pessoas que não participaram do projeto encontram obstáculos. A decisão inadequada seria dispensar observação de tarefas com base apenas na convicção interna.
Defina o que significa concluir a tarefa, observe usuários pertinentes e registre os obstáculos. Diferencie familiaridade com a solução de competência para avaliar seu uso. Esse caso também pode envolver a maldição do conhecimento; a discrepância entre equipe e usuários não basta para atribuir Dunning-Kruger.
Como identificar sem rotular pessoas
Procure uma discrepância documentada entre a avaliação de desempenho e um critério independente. A previsão era verificável? O resultado mede a mesma habilidade? A pessoa conhecia as condições? Confiança, eloquência e cargo não substituem essas perguntas.
Confundidores incluem tarefas ambíguas, feedback insuficiente, critérios mal comunicados e medidas ruidosas. Também é possível que uma pessoa saiba executar, mas estime mal sua posição em relação a outras. Autoavaliação absoluta e posição relativa são perguntas diferentes, e a análise precisa preservar essa diferença.
Como melhorar a calibração
- Defina uma tarefa e critérios de qualidade observáveis.
- Peça previsões específicas, com grau de confiança registrado.
- Compare previsões e resultados usando a mesma definição.
- Ofereça feedback sobre erros concretos e como verificá-los.
- Inclua revisão independente em decisões de maior impacto.
- Repita a avaliação em tarefas comparáveis antes de generalizar.
Um teste pontual não resume a capacidade de alguém. Acompanhe o aprendizado e registre as condições em que a pessoa melhora ou encontra dificuldade. A recomendação operacional é criar um processo de calibração, sem prometer que ele elimina excesso de confiança ou explica todas as diferenças de desempenho.
Uso responsável em marketing
Evite mensagens que humilhem o público ou sugiram que quem discorda não tem competência para entender. Uma oferta educativa deve comunicar o que será aprendido e os critérios de prática e avaliação. Não atribua um efeito psicológico ao cliente para pressioná-lo a comprar uma formação.
Em pesquisas, trate erros como informação sobre tarefa e contexto. Obtenha consentimento adequado e limite a coleta ao necessário. Se a equipe usa autoavaliações em treinamento, explique como os dados serão interpretados e evite transformá-los em uma classificação geral de inteligência.
Como diferenciar conceitos próximos
Dunning-Kruger envolve a relação entre desempenho e avaliação da própria competência em uma tarefa. A confirmação envolve favorecer evidências compatíveis com uma crença. A sobrevivência envolve observar apenas casos que permaneceram na amostra. A ancoragem envolve uma referência inicial na estimativa. Nenhum desses nomes substitui medir desempenho; discordância ou confiança alta, sozinhas, não identificam um efeito.
Evidências, controvérsias e a curva popular
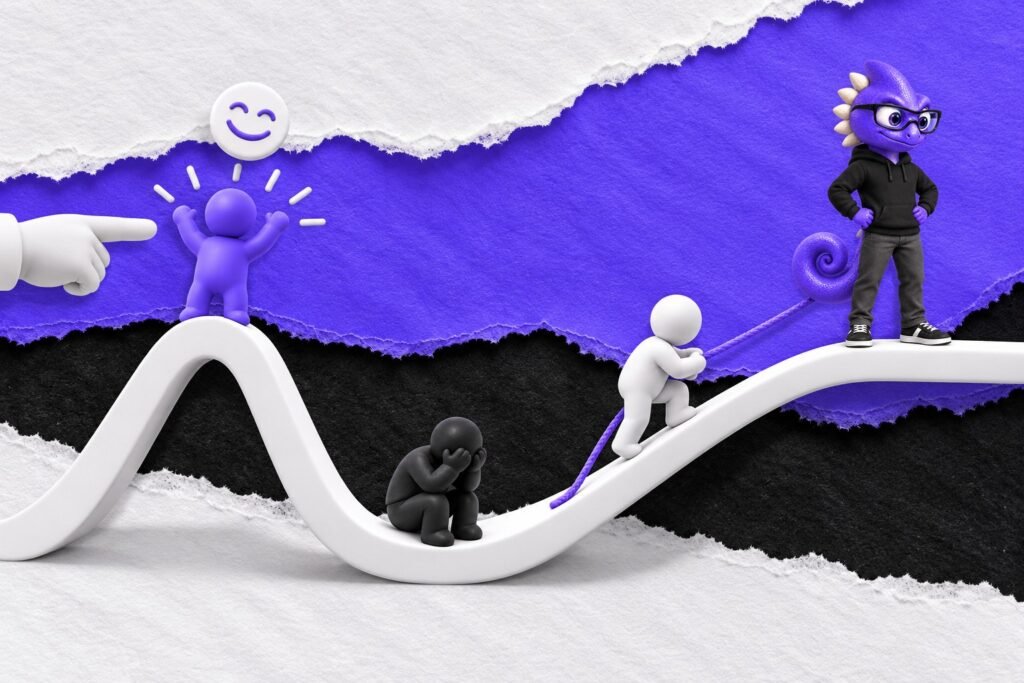
O estudo original, os trabalhos posteriores e a crítica estatística têm escopos distintos. A curva popular com um pico de confiança de iniciante, uma queda e uma subida de especialista não deve ser apresentada como trajetória universal comprovada pelo artigo de 1999. Uma relação entre grupos em um estudo não demonstra a evolução de uma pessoa ao longo do aprendizado.
O Cognitive Bias Codex, mapa visual de vieses de Buster Benson e John Manoogian III, serve para organizar o tema, sem comprovar o efeito. Os exemplos desta página são hipotéticos e não diagnosticam indivíduos. Na próxima revisão de relatório, substitua a pergunta sobre quem parece mais confiante por uma demonstração verificável do cálculo. Registre a previsão e o resultado para que a equipe possa aprender com a diferença.