Experimentação rigorosa na era da IA generativa: como testar hipóteses sem afogar o marketing
Promessa: Para especialistas em CRO, analistas de performance e gestores de produto: a diferença prática entre testes cosméticos gerados em lote e experimentos de valor estrutural com poder estatístico real.
A inteligência artificial transformou a capacidade de gerar variações experimentais. Se antes uma equipe levava duas semanas para debater três hipóteses de títulos e layouts para uma landing page, hoje ferramentas geram 30 variantes em poucos segundos.
No entanto, essa facilidade criou uma crise silenciosa nos programas de experimentação e CRO: a saturação de testes triviais.
Como analisou Marty Cagan em Experimentation, AI and the Product Model, a capacidade de rodar testes em massa não melhora automaticamente o negócio se a equipe não souber distinguir entre testes de otimização pontual e experimentos de descoberta estratégica.
Testar sem critério matemático gera um efeito colateral grave: falsos positivos em série. Quando você testa 20 variações geradas por IA ao mesmo tempo em uma página com tráfego moderado, a probabilidade estatística de que uma delas “vença” por pura aleatoriedade (erro tipo I) passa de 60%. O time comemora uma falsa vitória, aplica a mudança e o faturamento continua idêntico.
Os dois tipos de experimento: Otimização vs. Descoberta
Para estruturar um programa maduro de testes na era da IA, o primeiro passo é separar claramente os dois níveis de experimentação:
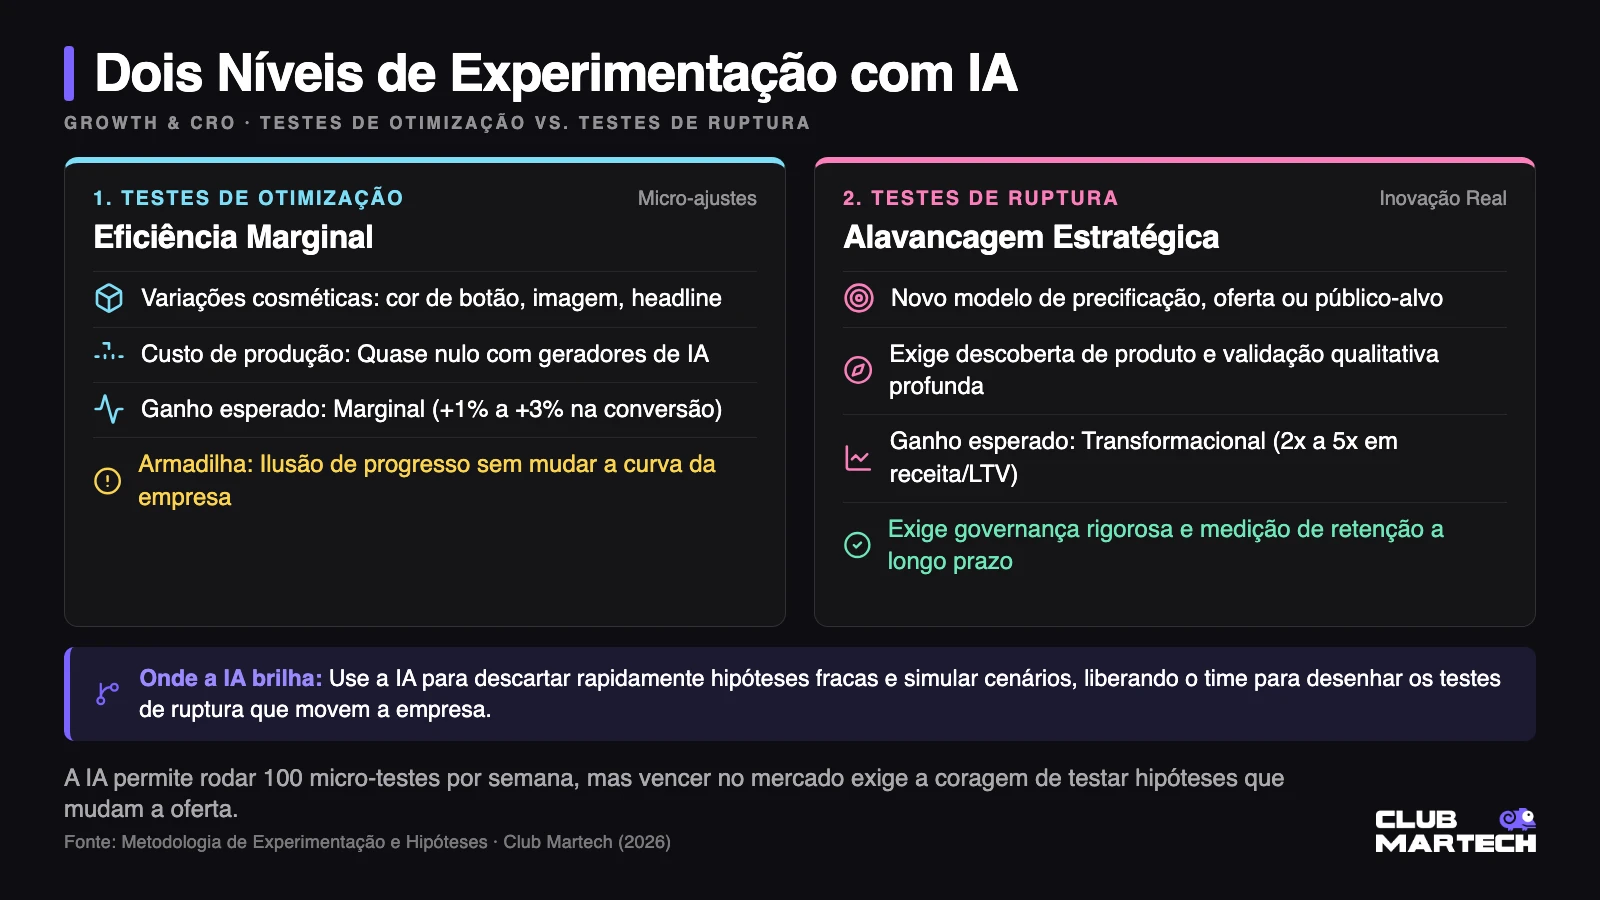
- Testes de Otimização: Ajustam detalhes de superfície de uma proposta de valor já validada (ex.: ordenar campos de um checkout, refinar a clareza de um botão). A IA é útil aqui para gerar micro-variações, desde que o tráfego suporte o tamanho da amostra.
- Testes de Descoberta: Validam se o problema que você está tentando resolver é real e se a sua solução atende aos critérios essenciais de viabilidade: valor percebido, usabilidade, viabilidade técnica e sustentabilidade financeira. Aqui, a IA serve para prototipar rápido, não para terceirizar o pensamento crítico.
O risco da divisão excessiva de tráfego (MDE e Amostragem)
O erro mais comum cometido por equipes que adotam ferramentas automatizadas de IA é fragmentar o tráfego em dezenas de variantes simultâneas.
Existe uma restrição matemática inevitável: quanto menor o tráfego alocado por variante, maior o Efeito Mínimo Detectável (MDE) necessário para atingir significância estatística.
Se uma página recebe 10.000 visitantes por mês com taxa de conversão base de 3%, você não pode rodar um teste A/B/C/D/E/F e esperar detectar um ganho sutil de 5%. Para conseguir significância com 95% de confiança estatística e 80% de poder (power), o teste precisaria rodar por seis meses — tempo durante o qual sazonalidade e mudanças de mercado invalidam qualquer conclusão.
A regra de ouro da experimentação com rigor: * Menos variantes, hipóteses mais fortes. Prefira testar um conceito estruturalmente diferente (A vs. B) que tenha potencial de mover a agulha em 25% a testar cinco variações de sinônimos gerados por prompt.
Como desenhar hipóteses que sobrevivem ao teste
Uma boa hipótese experimental nunca começa pela ferramenta; começa pelo dado comportamental:
“` Porque observamos [dado quantitativo ou qualitativo real], Acreditamos que [intervenção estrutural específica] Vai gerar [mudança mensurável de comportamento / outcome], Confirmado quando [métrica primária atingir significância estatística sobre o controle]. “`
### O que NÃO é uma hipótese: > “Vamos pedir à IA para reescrever a página inteira em 5 tons diferentes para ver qual vende mais.”
### O que É uma hipótese orientada a outcomes: > “Porque 68% dos usuários abandonam o formulário no campo de telefone (dado de funil), acreditamos que remover a exigência do telefone e validar a identidade via link mágico por e-mail aumentará a taxa de conversão em pelo menos 18%, confirmado com nível de confiança de 95%.”
O papel da instrumentação em Martech
Nenhum algoritmo de IA ou ferramenta de testes substitui uma camada limpa de dados primários. Se o seu Google Tag Manager dispara eventos duplicados, se o Consent Mode bloqueia metade dos cookies ou se a API de Conversões (CAPI) tem atraso no envio, o seu teste A/B estará otimizando em cima de alucinação de dados.
O operador de martech precisa garantir que: 1. O evento de conversão primária esteja unificado no lado do servidor. 2. O grupo de controle seja preservado sem vazamento de variantes (persistência de cookie first-party). 3. A métrica de guard-rail (ex.: cancelamentos, devoluções, churn) seja acompanhada em paralelo para garantir que um aumento temporário de conversão não destrua o LTV.
### Ferramentas e leituras recomendadas – Calcule previamente o volume de visitantes necessário com a nossa Calculadora de Tamanho de Amostra e Significância para Testes A/B. – Aprofunde o conceito de resultado de impacto no verbete Outcome e evite a esteira descrita em Output. – Entenda a arquitetura de dados e testes em A/B Testing para Produto: guia técnico para times de desenvolvimento.
Sugestão de imagem de destaque: Fotografia em visão macro de uma bancada de laboratório de alta precisão com vidrarias graduadas transparentes e iluminação pontual limpa, representando medição científica exata em contraste com o ruído de fundo.