

A xAI e seu assistente Grok entram na rotina de comunicação corporativa por um motivo específico: a capacidade de trabalhar com conversas e tendências em tempo próximo do “agora”, especialmente dentro do ecossistema do X. Para times que lidam com volume alto de menções, reclamações públicas e demandas repetitivas, isso representa uma mudança de processo — não apenas de ferramenta.
Este artigo mostra quando faz sentido usar xAI, como desenhar um workflow de triagem e atendimento, quais métricas provam ganho de eficiência e quais controles reduzem risco antes de escalar.
O que é a xAI e o que muda na rotina de comunicação
A xAI é a empresa de inteligência artificial que desenvolve o Grok, um assistente conversacional que compete diretamente na categoria de chatbots e assistentes corporativos. Para comunicação, o ponto relevante não é “mais um chatbot” — é o encaixe operacional: como o assistente entra no processo para reduzir tempo de reação, padronizar respostas e escalar triagens.
Dois elementos mexem diretamente com a rotina de comunicação:
- A proximidade com o ecossistema do X e as possibilidades de interpretação de conversas públicas em tempo real.
- A proposta de um assistente com personalidade mais opinativa, que pode ser vantagem (tom mais humano) ou risco (tom desalinhado com a marca).
Pense no time de comunicação como uma war room com um painel de controle em tempo real: de um lado, sinais do público (menções, tendências, threads); do outro, filas operacionais (tickets, aprovações, escalonamentos). O valor do Grok aparece quando ele conecta esses dois lados num único fluxo — identificar o tema, sugerir resposta, abrir demanda, registrar contexto e acompanhar SLA.
Regra de bolso para definir prioridade:
- Maior gargalo é volume de demandas repetitivas → priorize automação de atendimento e triagem.
- Maior gargalo é contexto e timing (crise, rumor, movimento de concorrente) → priorize monitoramento, sumarização e geração de briefing.
- Risco reputacional alto (setor regulado) → priorize governança e humano no loop antes de escalar qualquer automação.
Para orientar o desenho do uso, consulte a documentação oficial Sobre o Grok (X Help). Funcionalidades mudam com frequência, então valide no seu ambiente antes de comprometer o processo.
⚠️ A xAI não existe mais como empresa independente
Antes de qualquer análise do produto, uma correção factual que ainda circula errada na maior parte do conteúdo disponível: a SpaceX adquiriu a xAI em 2 de fevereiro de 2026, e a operação foi rebatizada como SpaceXAI em julho do mesmo ano. Referências a “xAI, a empresa de IA de Elon Musk” estão desatualizadas desde então.
Todas as versões do Grok, de 2023 a 2026
| Versão | Data | O que mudou |
|---|---|---|
| Grok-1 | 03/11/2023 | Beta restrito a assinantes do X Premium |
| Grok-1 (pesos abertos) | 17/03/2024 | 314 bilhões de parâmetros sob licença Apache 2.0 |
| Grok-2 | 14/08/2024 | Geração de imagem via Flux |
| Grok 3 | 17/02/2025 | Cerca de 10x mais capacidade de computação; estreia do DeepSearch |
| Grok 4 e 4 Heavy | 09/07/2025 | Carro-chefe mais versão multiagente |
| Grok Imagine | 28/07/2025 | Geração de vídeo |
| Grok 4.1 | 17/11/2025 | Redução de alucinação |
| SpaceX adquire a xAI | 02/02/2026 | Operação incorporada; rebatizada SpaceXAI em julho |
| Grok 4.5 | 08/07/2026 | Nova arquitetura base |
| Grok 4.6 | 12/08/2026 | Versão atual; corte de conhecimento em 01/02/2026 |
Modelos disponíveis hoje
| Modelo | Contexto | Preço (US$/1M tokens) |
|---|---|---|
grok-4.6 | 500K | 2 / 6 (abaixo de 200K) · 4 / 12 (acima) |
grok-4.3 | 1M | 1,25 / 2,50 |
grok-build-0.1 | 256K | ver documentação |
Vale registrar uma prática incomum do fornecedor: Grok 4, 3 e 2 desapareceram da documentação sem anúncio formal de descontinuação. Para quem mantém integração, isso significa que a régua de previsibilidade é menor que a de Anthropic ou OpenAI, ambas com páginas públicas de depreciação e prazos declarados.
Os preços de assinatura ao consumidor que circulam — SuperGrok Heavy em torno de US$ 300 e X Premium+ a US$ 40 — vêm de agregadores, sem página oficial verificável. Trate como estimativa.
O passivo reputacional que precisa entrar na decisão
Nenhuma avaliação honesta do Grok para uso corporativo pode omitir o histórico de incidentes. Não é questão de opinião sobre a empresa: são fatos documentados com investigações regulatórias em curso, e representam risco de associação de marca.
- Maio de 2025: o modelo passou a inserir referências a “genocídio branco” em respostas não relacionadas.
- 8 de julho de 2025: o episódio que ficou conhecido como “MechaHitler”, com o chatbot produzindo conteúdo antissemita.
- Deepfakes sexuais — a crise mais grave. Apuração da Wired identificou cerca de 6.700 imagens sexualizadas geradas por hora no Grok Imagine, volume 84 vezes maior que a soma dos cinco maiores sites de deepfake, com aproximadamente 2% do material aparentando envolver menores.
As consequências institucionais seguem abertas: banimentos temporários na Indonésia, Malásia e Filipinas (todos revertidos), investigações da Comissão Europeia, do Ofcom britânico, da França, da Irlanda e da Califórnia, além de processos movidos por vítimas individuais nos Estados Unidos e no Reino Unido.
Há também um passivo ambiental em Memphis, onde a operação instalou 59 turbinas a gás sem licença federal, com ação judicial movida pela NAACP.
O que isso significa na prática
Para uso técnico interno — análise de dados, código, prototipagem —, o histórico pesa menos. Para qualquer aplicação voltada ao público, comunicação de marca ou conteúdo publicável, o risco de associação é concreto e mensurável. Recomendo especialmente cautela com o Grok Imagine em contexto corporativo, dado o escopo das investigações abertas.
Se o objetivo é acesso a dados do X em tempo real — o diferencial real do produto —, avalie se a mesma necessidade não se resolve pela API da plataforma combinada a um modelo de outro fornecedor.
Fontes
- Documentação de modelos — SpaceXAI
- Panorama de modelos de IA em 2026 — Club Martech
4 casos de uso do Grok para comunicação corporativa
Os quatro casos abaixo geram impacto real porque atacam desperdício de tempo e reduzem retrabalho. O foco é redesenhar o processo para aumentar eficiência — não automatizar por automatizar.
1. Central de respostas para FAQs públicas (pré-crise)
Quando o público pergunta sempre as mesmas coisas (prazo, preço, status, política), o Grok sugere respostas consistentes com base numa biblioteca aprovada. A regra é simples: o assistente redige, o time aprova, e só então você libera autopost ou respostas semi-automáticas.
Workflow mínimo:
- Detectar intenção (dúvida, reclamação, denúncia, elogio).
- Buscar resposta em playbook aprovado.
- Gerar proposta de resposta com tom da marca.
- Aprovar (humano) e responder.
2. Triagem de menções e roteamento por severidade
A triagem manual vira gargalo quando menções explodem. O assistente classifica por severidade e encaminha para a fila correta (atendimento, jurídico, PR, produto).
Critérios de severidade alta:
- Ameaça de processo judicial
- Dados pessoais expostos
- Influenciador relevante envolvido
- Potencial de cobertura de imprensa
- Efeito dominó (múltiplas menções em curto intervalo)
3. Briefings diários de reputação e tendências
Em vez de ler centenas de posts, o time recebe um briefing com temas, argumentos e riscos. Aqui, a xAI funciona como analista assistente, não como porta-voz.
Entregável operacional — briefing em 1 página com:
- Top 5 temas do período
- Sentimentos dominantes
- Perguntas recorrentes
- Posts de alto alcance
- Recomendação de ação
4. Copiloto para comunicados e Q&A interno
Para comunicação interna, o ganho é padronização. O assistente gera versões (curta, média, longa), FAQs e mensagens para lideranças, reduzindo ciclos de revisão.
Regra de governança: o assistente nunca “inventa” política. Ele só reescreve a partir de fontes internas aprovadas.
Workflow de atendimento com Grok: do post no X ao ticket sem perder contexto
A maior falha em iniciativas de chatbot é focar só na resposta. Comunicação precisa de rastreabilidade: quem respondeu, por quê, com base em qual informação e como isso virou ação interna.
Etapa 1: captura e normalização
- Entrada: menção, DM, comentário.
- Normalização: remover duplicados, agrupar por thread, identificar idioma.
- Saída: um “evento” com ID único.
Etapa 2: classificação e severidade
O Grok classifica intenção e severidade, mas o modelo deve preencher um formulário estruturado — não texto livre.
Campos recomendados:
| Campo | Opções |
|---|---|
| Intenção | dúvida, reclamação, crise, imprensa, fraude |
| Tema | produto, entrega, privacidade, cobrança |
| Severidade | baixa, média, alta |
| Confiança | 0 a 1 |
| Ação sugerida | responder, escalar, ignorar, pedir dados |
Etapa 3: resposta proposta e checklist de risco
Antes de responder, rode um checklist curto:
- Há dados pessoais no texto?
- A resposta faz promessa de prazo ou compensação?
- O tema é regulatório?
Se “sim” em qualquer item, a aprovação humana é obrigatória.
Etapa 4: criação de ticket e roteamento
Ao escalar, abra ticket com contexto completo (thread, resumo, severidade, rascunho de resposta, evidências). Integre via Zapier ou n8n para automatizar a abertura.
Padrão de roteamento:
- Alta severidade → PR + Jurídico
- Reclamação recorrente → Produto
- Cobrança → Suporte/Financeiro
Etapa 5: fechamento com aprendizado
O fechamento não é só “ticket resolvido”. Registre:
- Causa raiz
- Macrotema
- Tempo até primeira resposta
- Modelo de resposta aprovado
Esse dataset vira o playbook vivo do time.
Cuidado prático: não deixe o fluxo virar caixa-preta. O que escala eficiência também escala erro. Prefira menos automação com mais qualidade na primeira iteração.
Métricas que provam ganho de eficiência (e onde quase todo mundo erra)
Sem métrica, a conversa vira opinião. Para comunicação, as métricas precisam capturar dois planos: performance do atendimento e saúde reputacional.
Métricas de atendimento (processo)
| Métrica | Meta para piloto |
|---|---|
| Tempo até 1ª resposta (FRT) | Reduzir 30% em 30 dias |
| Tempo médio de resolução (TTR) | Reduzir 15-25% após estabilizar triagem |
| Taxa de reabertura | Manter estável ou reduzir |
| Deflexão (autoatendimento) | Acompanhar junto com CSAT |
Métricas de qualidade (comunicação)
| Métrica | Meta para piloto |
|---|---|
| CSAT/nota pós-interação | Subir 0,3 a 0,7 ponto em 60 dias |
| Taxa de escalonamento correto | Acima de 90% após calibrar regras |
| Taxa de retrabalho editorial | Quantas respostas foram reescritas por tom ou política |
Como medir ganho sem distorcer a análise
O erro comum é comparar períodos com volumes diferentes ou eventos externos (campanhas, crise). Em vez disso:
- Separe por tipo de demanda (FAQs, reclamações, alta severidade).
- Rode A/B por fila: fila A com assistente, fila B como controle.
- Avalie por coortes semanais.
Checklist de otimização quinzenal:
- Top 20 intenções que o assistente classifica errado
- Respostas com maior taxa de retrabalho
- Temas que geraram escalonamento indevido
- Novas regras de severidade a calibrar
Para times maduros, o objetivo não é “100% automatizado”. É “100% rastreável”, com ganho líquido de eficiência e risco controlado.
Governança e riscos ao usar xAI em comunicação
Se o canal é público, governança não é burocracia — é proteção de marca. A combinação de LLM com redes sociais aumenta a chance de alucinação, vazamento de contexto e inconsistência de tom. Trate isso como risco operacional.
Controles mínimos antes do piloto
- Política de dados: o que pode entrar no prompt e o que é proibido.
- Níveis de automação: resposta automática só para FAQs de baixa severidade.
- Logs e auditoria: guardar entrada, saída, versão do prompt e aprovador.
- Playbook de exceções: quando parar a automação completamente.
Referenciais de governança
O NIST AI Risk Management Framework (AI RMF) organiza risco por categorias e controles. Para riscos específicos de aplicações com LLM, o OWASP Top 10 for LLM Applications é um checklist prático para ameaças como prompt injection e vazamento de dados.
Riscos específicos para comunicação
- Tom e personalidade: se o assistente improvisa, você perde consistência de marca.
- Dependência de plataforma: quando o diferencial depende de um ecossistema fechado, mudanças de acesso impactam o processo inteiro.
- Informação não verificada: respostas convincentes, porém erradas, geram retratação pública.
Critério para habilitar autopost:
- Base de respostas aprovada e versionada.
- Taxa de erro por tom abaixo de 2%.
- Revisões amostrais diárias por 2 semanas sem incidentes.
Como decidir entre xAI e outros assistentes com base no seu processo
A escolha do assistente não começa pelo modelo “mais forte”. Começa pelo gargalo e pelas integrações que sustentam o processo.
Contexto em tempo real e social listening
Se o diferencial é responder a movimentos do debate público, a xAI pode ser atraente pelo posicionamento e pelas integrações no ecossistema do X.
Maturidade de ecossistema e governança corporativa
Se a prioridade é stack corporativo, controles e consistência de produto, avalie também OpenAI, Anthropic e Google Gemini, além das camadas de segurança e observabilidade do seu ambiente.
Integração com workflow e automação
Se o problema é processo, o modelo é só um componente. Você ganha mais criando um bom roteamento e um dataset sólido de respostas do que trocando de LLM toda semana.
Como pilotar sem travar a operação
- Semana 1: classificador e severidade, sem responder automaticamente.
- Semana 2: resposta sugerida com aprovação humana.
- Semana 3: automação limitada para FAQs de baixa severidade.
- Semana 4: otimização com métricas e revisão de prompts.
Critério de sucesso do piloto: reduzir FRT e retrabalho sem aumentar incidentes de tom ou política.
Próximos passos para implementar xAI com segurança
Trate o assistente como parte de um sistema, não como um robô que responde. Comece definindo as filas e intenções que mais consomem tempo do time. Depois, desenhe o workflow de triagem, roteamento e registro. Implemente um piloto com humano no loop e metas claras de eficiência.
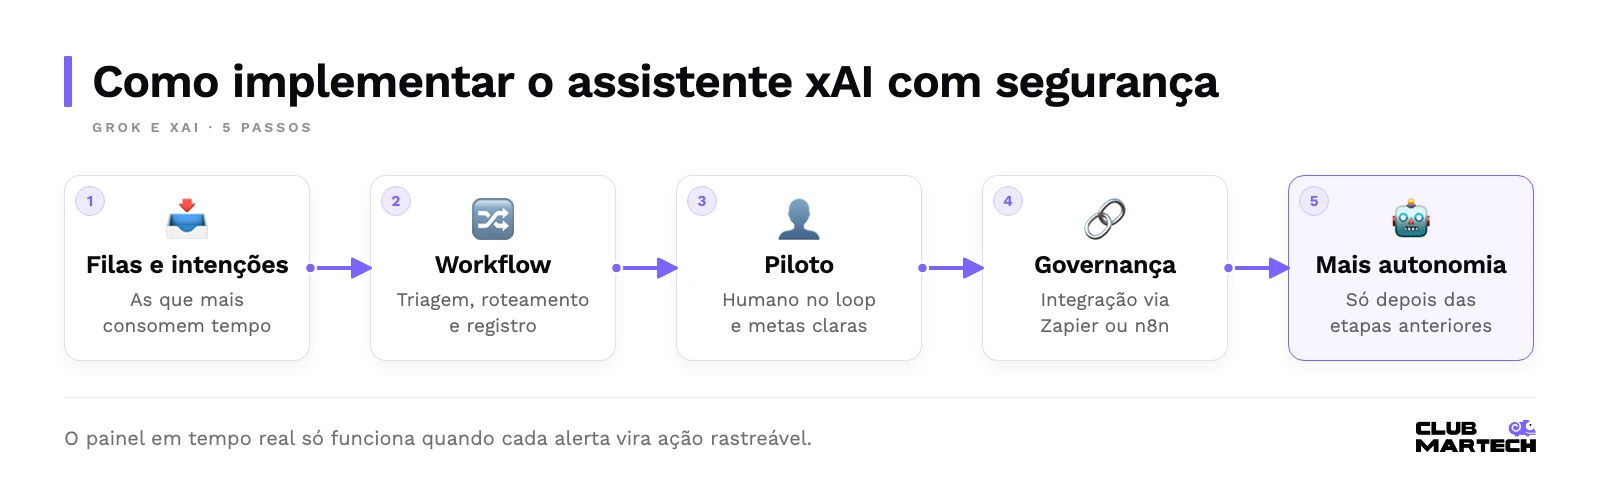
O painel de controle em tempo real só funciona quando cada alerta vira ação rastreável. Defina governança, use automação via Zapier ou n8n para integrar processos e só então aumente o nível de autonomia do assistente. O objetivo é direto: responder mais rápido, com consistência, e transformar conversa em aprendizado operacional.
Leia também
- Modelos de IA em 2026: versões atuais, preços e como escolher — o panorama comparativo de todos os modelos
- Nano Banana · GPT Image · Seedream — geração de imagem
- Seedance · Higgsfield — geração de vídeo
- Kimi · DeepSeek — modelos de pesos abertos
- Engenharia de prompt — extrair mais de qualquer modelo
