Em 17 de novembro de 2026, o Google publicou o guia técnico Allow Google-Agent traffic, que mostra como liberar o Google-Agent no CDN (rede de distribuição de conteúdo), no firewall de aplicação web (WAF) e em serviços de detecção de bots. O tráfego de agentes de IA que navegam e agem em nome de pessoas chega aos sites, e regras de segurança pensadas para robôs podem barrá-lo.
Segundo o Google, Google-Agent é o nome usado por agentes hospedados na infraestrutura da empresa para navegar na web e executar ações a pedido do usuário. A página não diz qual produto aciona o agente nem se ele respeita o robots.txt.
O que foi anunciado
Segundo a documentação do Google:
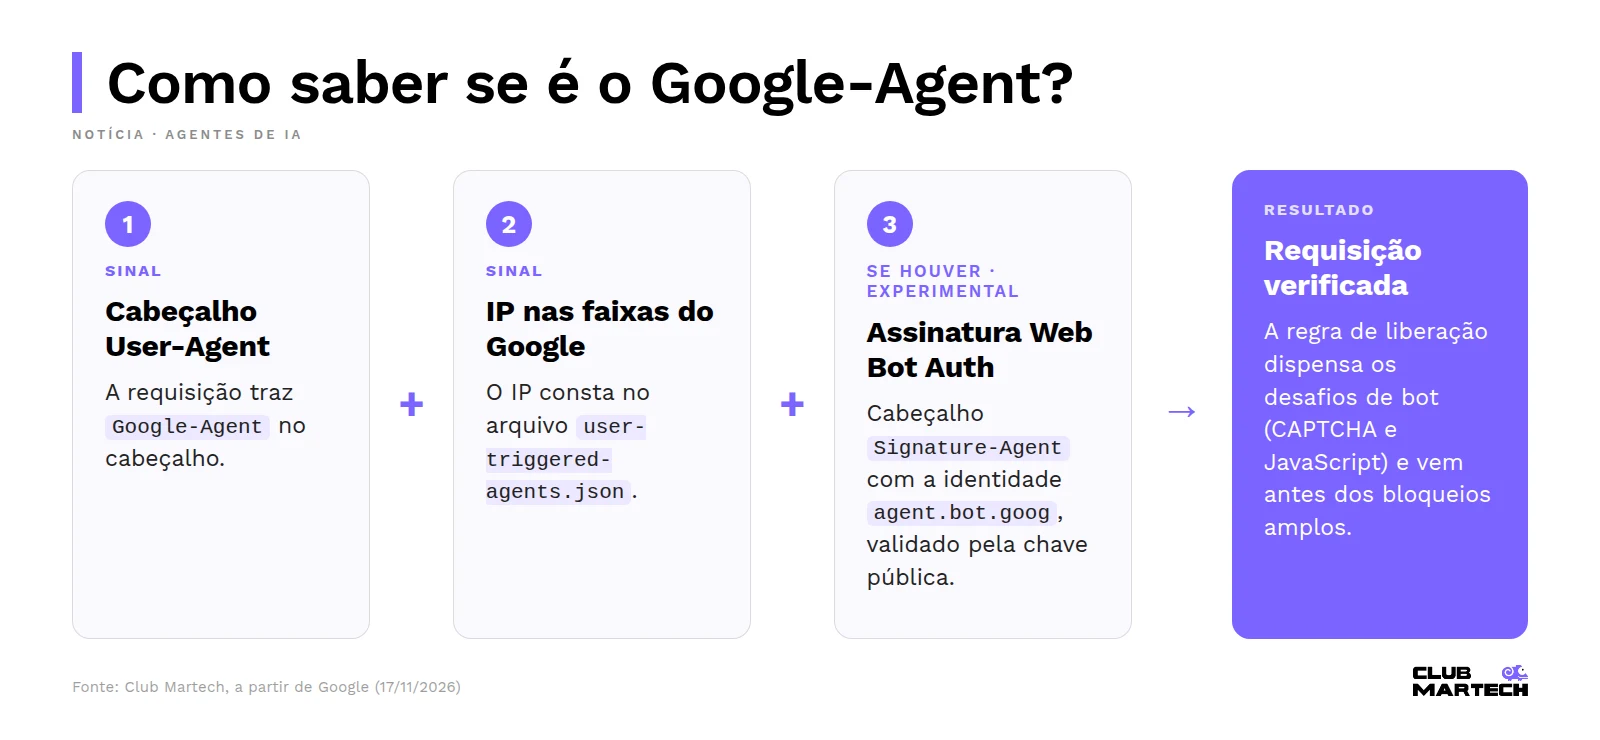
- Como reconhecer: o cabeçalho User-Agent contém “Google-Agent” e o IP da requisição consta no arquivo JSON de faixas dos agentes disparados por usuário (user-triggered-agents.json). A página não descreve verificação por DNS reverso.
- Assinatura experimental: o Google também assina requisições com Web Bot Auth, padrão experimental baseado na RFC 9421. A identidade é agent.bot.goog, e as requisições assinadas trazem os cabeçalhos Signature-Agent, Signature e Signature-Input.
- Recomendação: liberar o tráfego de forma explícita no CDN, no WAF ou no serviço de bots evita barrar pedidos legítimos sem abandonar os controles de segurança que já existem.
- Quando o provedor não verifica sozinho: confirmar o cabeçalho, conferir o IP no JSON, validar a assinatura quando houver e só então dispensar os desafios de bot nas requisições verificadas.
- Histórico: o changelog de crawling do Google registra o guia em 17 de novembro. O user agent já tinha sido anunciado em 20 de março de 2026, com liberação gradual nas semanas seguintes.
Por que isso importa para quem trabalha com marketing
O Google-Agent age no site: pode usar a busca interna, aplicar filtros, abrir páginas de produto, montar um carrinho ou iniciar uma reserva. A documentação lista esses passos entre os pontos que a regra de liberação precisa cobrir.
Se o WAF tratar esse tráfego como bot de nuvem e responder com CAPTCHA, o agente pode não concluir a tarefa. A página do Google não mede esse efeito. Em lojas e sites de reserva, a consequência possível é uma jornada interrompida. A decisão de permitir ou não esse acesso é de negócio, e não só de infraestrutura: a documentação trata de como permitir o tráfego e não traz orientação de bloqueio específica para o Google-Agent.
Outras empresas tomam o caminho oposto. A United Airlines vai restringir agentes pessoais de IA de terceiros não autorizados, e o Brave Search vai cifrar os links dos resultados para frear scrapers. A United restringe, o Brave cifra e o Google publica o guia para liberar.
O que conferir na sua operação
Segundo a documentação do Google, a regra de liberação deve seguir estes pontos:
- Ordem das regras: vir antes de bloqueios amplos de ASN de nuvem e datacenter, de regras gerenciadas de bots e de políticas contra categorias de agentes de IA.
- Desafios: pular CAPTCHAs e desafios de JavaScript, inclusive os widgets disparados na busca ou no envio de formulário.
- Percurso completo: cobrir busca do site, filtros, páginas de detalhe, carrinho, reserva e endpoints XHR, GraphQL ou api.
- Limite por IP: contar ou isentar as faixas verificadas, porque pedidos de várias pessoas saem do mesmo conjunto de IPs.
- Proxies e balanceadores: preservar o IP original, o User-Agent e, nas requisições assinadas, os três cabeçalhos de assinatura.
- Faixas atualizadas: manter regras baseadas em IP sincronizadas com o arquivo JSON do Google.
A liberação vale apenas para requisições que passam na verificação. Quem aceita qualquer pedido com o texto “Google-Agent” no cabeçalho abre a porta também para quem imita o nome.
E agora?
A documentação deixa pontos em aberto: se o Google-Agent segue o robots.txt, quais produtos o acionam e qual volume esperar. Sem essas respostas, o caminho é medir. Filtrar os logs do CDN pelo cabeçalho, ver quantas requisições foram barradas e em que etapa do site isso aconteceu mostra se existe perda real.