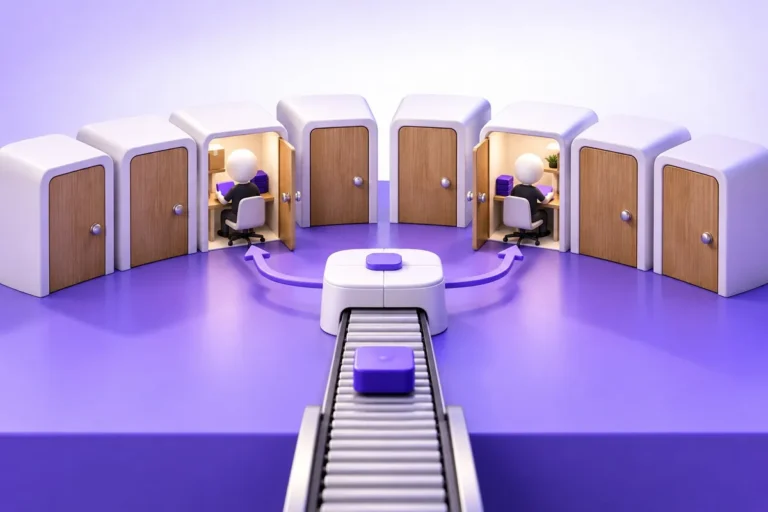
MoE
Mistura de especialistas ativa só parte do modelo por token. O Kimi K3 tem 2,8T de totais e 104B de ativos — e a memória se dimensiona pelos totais.

Mistura de especialistas ativa só parte do modelo por token. O Kimi K3 tem 2,8T de totais e 104B de ativos — e a memória se dimensiona pelos totais.
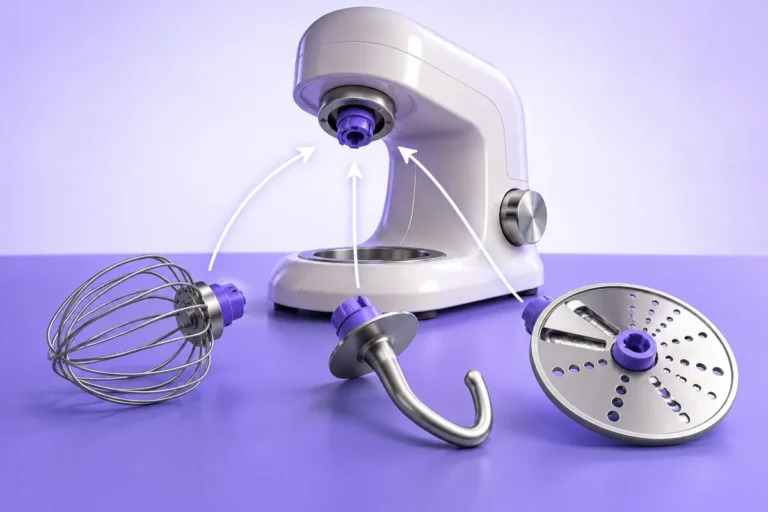
Treinado sobre dados amplos e adaptável a muitas tarefas. Quem cunhou o termo alertou: os defeitos da fundação passam para tudo o que se constrói nela.
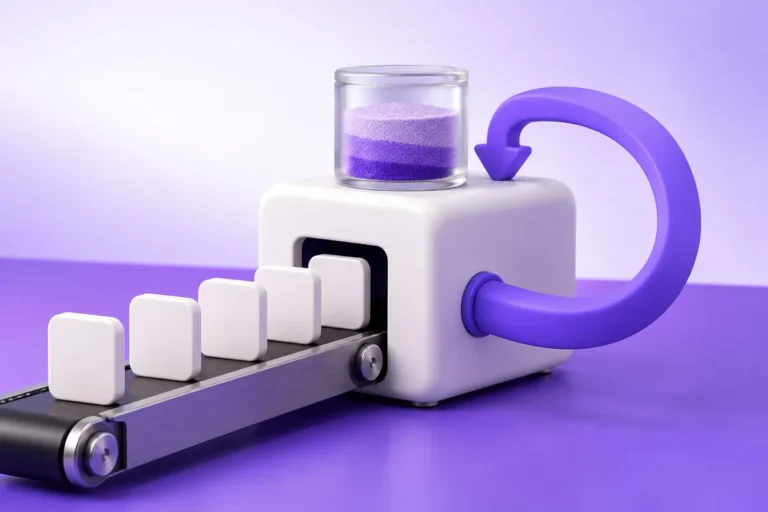
Processa sequências um elemento por vez. Foi substituída pelo Transformer e voltou reformulada, com 5× mais throughput de inferência.
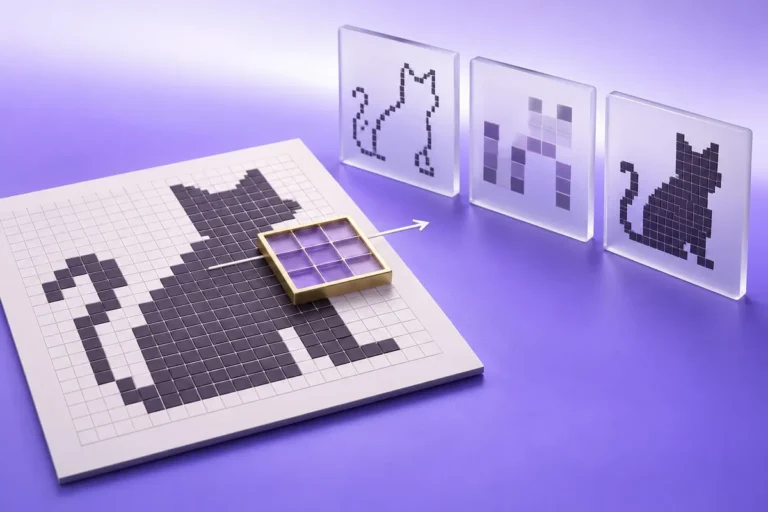
Rede convolucional processa imagens detectando padrões locais. Venceu o ImageNet 2012 por quase 11 pontos — e não saiu de cena.
Mecanismo que pesa a relevância de cada parte do texto. Ler os pesos como explicação do modelo é contestado na literatura desde 2019.
Introduz a não-linearidade que torna a rede capaz de representar relações complexas. A escolha dominante venceu por teste, não por teoria.
Parâmetro é aprendido no treino; hiperparâmetro é decidido antes. Só alguns hiperparâmetros importam — e quais mudam de problema para problema.
Sequência finita de passos precisamente definidos, na definição de Knuth. Dizer que o algoritmo decidiu transfere responsabilidade de quem escolheu.
RLHF usa preferência humana para alinhar modelos. Em 2026 o DPO substituiu o reforço clássico — por ser mais estável e mais barato.
O sistema aprende por consequência, não por exemplo. Um modelo admitiu erro que não cometeu em 98% das perguntas ao ser contestado.
Regime em que o modelo aprende com exemplos rotulados. O teto de qualidade é a qualidade do gabarito — e as referências da área erram mais do que se imagina.
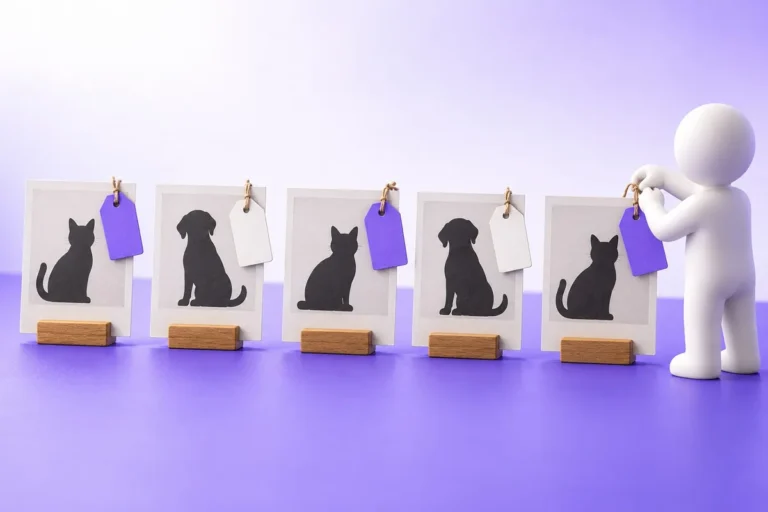
Label é a resposta correta nos dados de treino. Auditoria dos 10 conjuntos mais usados achou 3,3% de erro médio — e 5,83% no ImageNet.
Alinhamento faz o modelo seguir a intenção de quem o construiu. Tem custo reconhecido em capacidade — e não elimina jailbreak, viés nem explicação infiel.
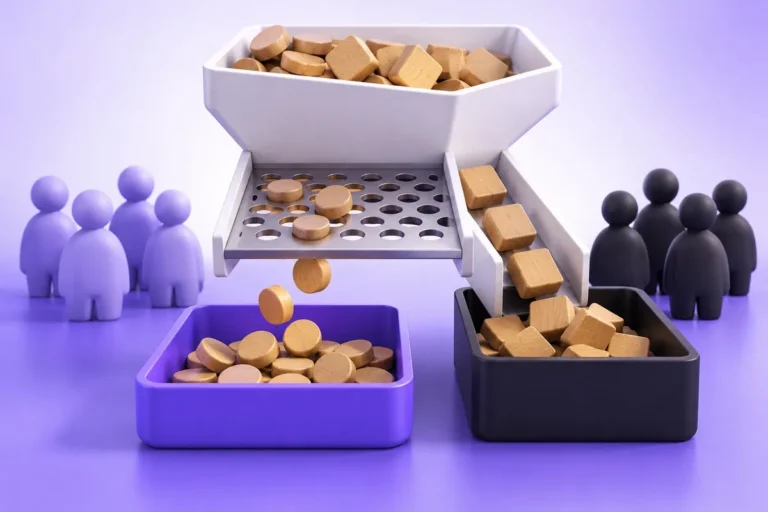
Viés algorítmico é errar sistematicamente mais para um grupo. A auditoria Gender Shades mediu até 34,7% de erro num subgrupo e 0,8% em outro, no mesmo sistema comercial.
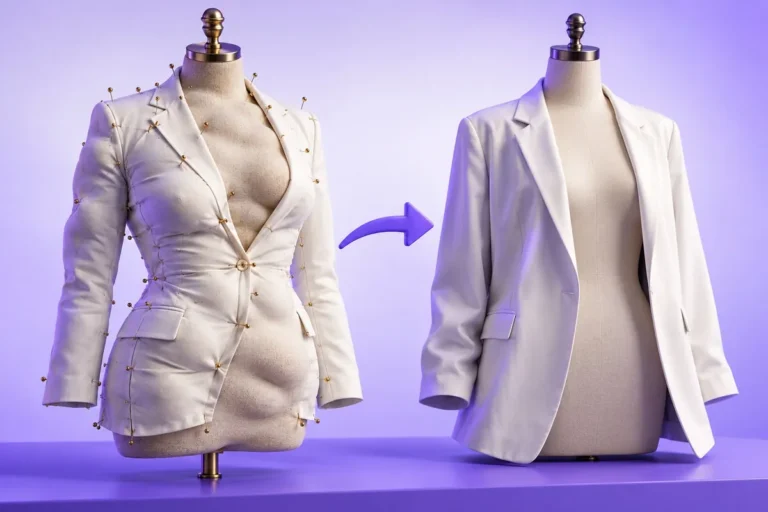
Sobreajuste é decorar o treino e falhar em dado novo. A versão moderna é o sobreajuste ao benchmark — quedas de até 13 pontos ao testar com problemas equivalentes e inéditos.