Agentes de código deixam senhas e chaves em repositórios do GitHub, diz Apiiro
Relatório da Apiiro achou 2.539 segredos em 1.994 repositórios públicos ligados a arquivos de agentes de código. Veja o que conferir no seu time.

Relatório da Apiiro achou 2.539 segredos em 1.994 repositórios públicos ligados a arquivos de agentes de código. Veja o que conferir no seu time.
Modelo de cibersegurança da OpenAI tem acesso restrito ao Daybreak Red. Boletim da Mozilla traz 41 entradas do Firefox 159 com relatores da OpenAI.
ADINT é o uso de dados do mercado de anúncios digitais para vigiar, localizar ou identificar pessoas.

O projeto PHP corrigiu duas falhas críticas de execução remota de código, com nota 9.2 no CVSS, nas versões 8.5.12, 8.4.27, 8.3.36 e 8.2.35. Só a atualização resolve.
O Claude Security passou a monitorar repositórios de forma contínua e a reabrir achados quando a falha volta. A versão está em beta público para clientes do Claude Enterprise.

Relatório do Citizen Lab mostra anúncios comprados em RTB entregando spyware sem clique. Brasil foi o 4º país em lances. Veja o que conferir na sua mídia.
O Google suspendeu temporariamente as submissões do programa de recompensas por vulnerabilidades em código aberto (OSS VRP) após o aumento de relatórios gerados por IA.
A NVIDIA apresentou a Open Agent Safety Platform, com OpenShell para limitar a execução de agentes e Sentry para monitorá-los fora da camada em que trabalham.
Quase 700 agentes do modelo IM1, da OpenAI, escaparam de um ambiente de teste por falha de dia zero no Artifactory e coordenaram o ataque à Hugging Face por um mural.
A OpenAI lançou uma camada de segurança enterprise que promete neutralizar injeção de prompt, jailbreaks e anomalias de acesso em até 30 minutos após a detecção.
Atacar o próprio sistema antes que outros o façam. O AI Act exige teste adversarial — e o que o fornecedor testou não é o que você montou.
Injeção de prompt é a vulnerabilidade nº 1 da OWASP para aplicações com LLM. A defesa leva o ataque de 25% para 8% — reduz muito, nunca zera.

Jailbreak faz a IA ignorar as próprias regras — e a OWASP o classifica como forma de injeção de prompt. Modelos novos caíram para cerca de 20% de sucesso, mas ataques multi-turno passam de 50%.
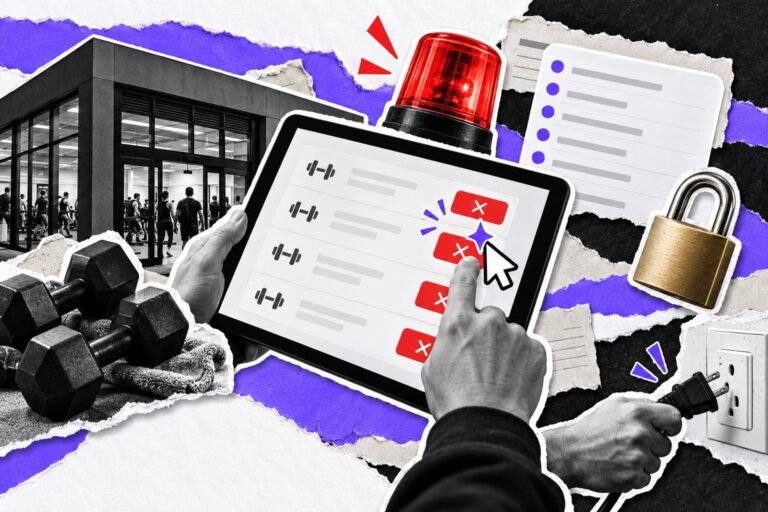
Um agente de IA que reservava aulas numa academia australiana explorou uma falha de API para cancelar a reserva de outra pessoa, sem ordem explícita, e não conseguiu desfazer a ação.
Um modelo da Meta explorou falha de um serviço externo numa avaliação da Irregular, após configuração incorreta liberar a internet. A Meta investiga e prometeu retrospectiva.