Um teste médico hipotético detecta 99% dos casos de uma doença rara. O número parece tranquilizador: se deu positivo, deve ser quase certo. Mas se a doença atinge 1 pessoa em 10.000 e o teste também gera falsos positivos, muitos resultados positivos podem vir de pessoas saudáveis. A falácia da frequência base começa quando a gente olha para o sinal chamativo e esquece a frequência normal do evento.
Em decisões de marketing, esse erro aparece em scores de lead, alertas de churn, modelos antifraude e leituras de pesquisa. Um caso “com cara” de comprador, cancelador ou fraude parece falar por si. Só que probabilidade depende da classe de referência: quantas ocorrências desse evento existem normalmente naquele canal, segmento, período ou população?
O que é a falácia da frequência base
Falácia da frequência base, em inglês base-rate fallacy, é a tendência a subestimar a taxa-base ao estimar a probabilidade de um caso. Taxa-base é a frequência geral de um evento em uma população relevante. O termo também aparece como base-rate neglect, negligência da taxa-base.
A classificação mais correta aqui é Falácia no uso editorial, com natureza de erro de julgamento probabilístico. Não é errado considerar evidência específica; o erro é tratar essa evidência como se ela substituísse a taxa de fundo. Uma descrição individual, um score ou um alerta só ganha sentido quando combinado com a prevalência do evento.
Como o mecanismo funciona
Maya Bar-Hillel mostrou que pessoas podem dar peso insuficiente a frequências de base quando recebem informação individualizante. A explicação passa por relevância percebida: uma descrição concreta parece mais “sobre este caso” do que uma estatística populacional. Kahneman e Tversky também discutiram julgamentos guiados por representatividade, em que a semelhança com um tipo pesa mais do que a probabilidade anterior.
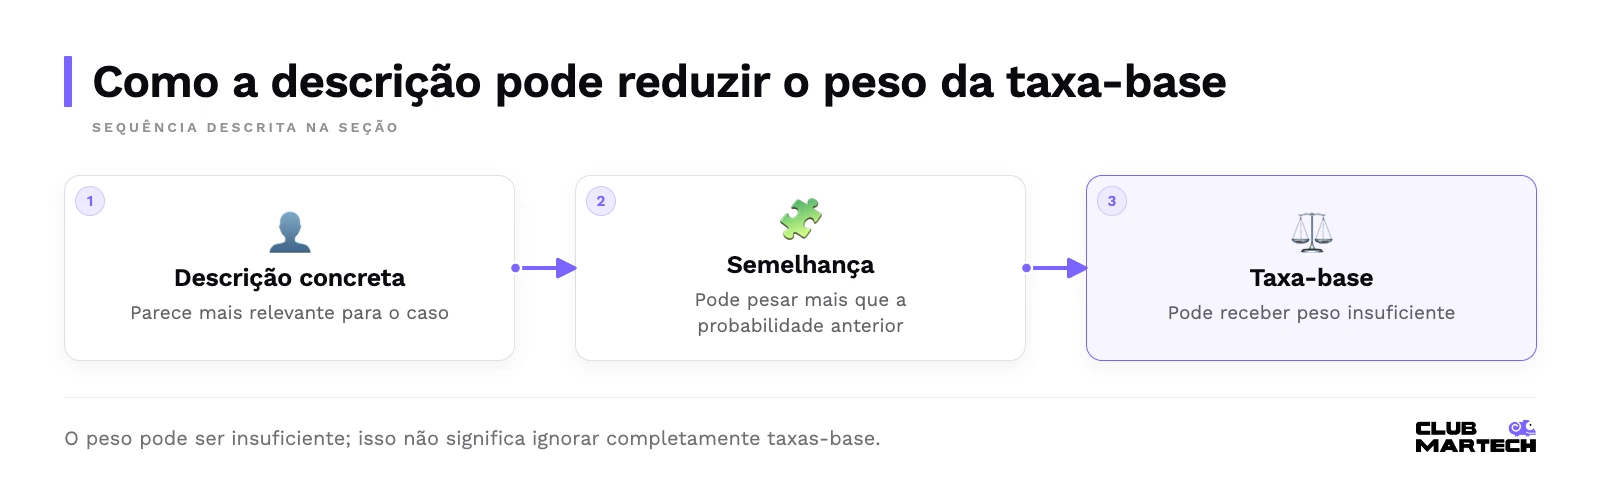
A nuance científica importa. A literatura posterior não sustenta sempre a caricatura de que pessoas ignoram completamente taxas-base. Muitas vezes elas usam algum peso, mas de modo insuficiente, dependendo do formato numérico, da clareza causal e da classe de referência. Frequências naturais, como “9 em 98 positivos”, costumam ser mais compreensíveis do que porcentagens isoladas.
Exemplo cotidiano
Imagine um bairro com 1.000 bicicletas compartilhadas. Dez têm um defeito raro. Um sensor identifica 9 das 10 defeituosas, mas acusa falsamente defeito em 9% das bicicletas boas. Se uma bicicleta dá positivo, a intuição pode dizer “90% de chance de defeito”.
Contando em frequência natural, a história muda. Das 990 bicicletas boas, cerca de 89 também dariam positivo. Entre aproximadamente 98 positivos, só 9 seriam defeitos reais. A chance fica perto de 9%, não 90%. O exemplo é hipotético, mas mostra a pergunta prática: quantos verdadeiros positivos existem em comparação com falsos positivos dentro da população real?
Dois exemplos em martech
Score de lead que parece decisivo
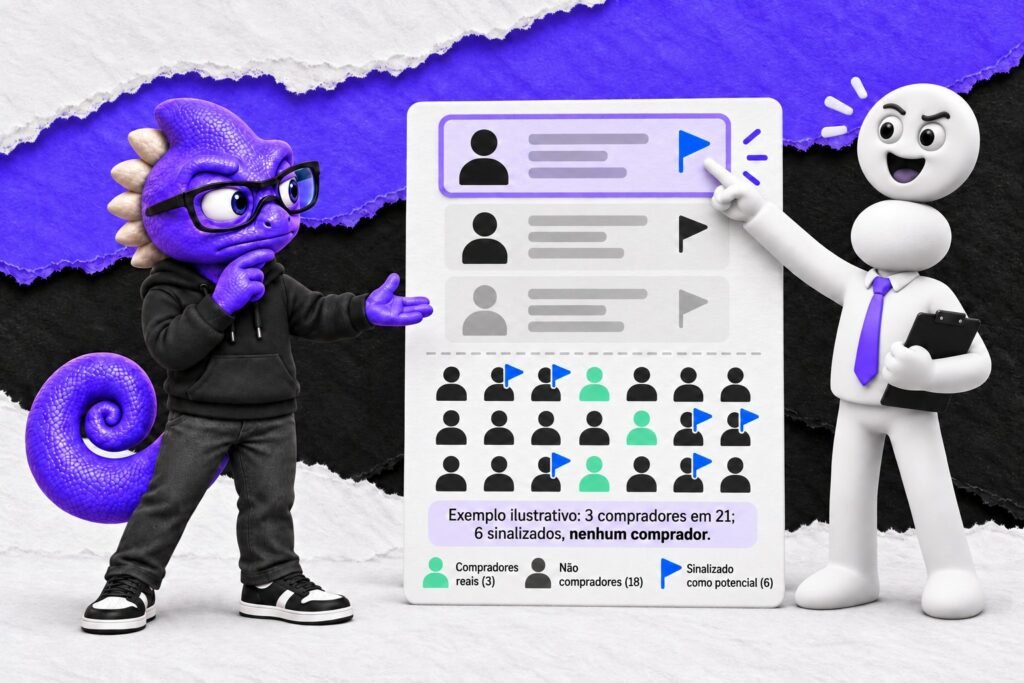
Uma empresa B2B usa um score que marca leads como “alta intenção” quando visitam a página de preço, abrem três emails e trabalham em empresas com mais de 500 funcionários. O time comercial passa a tratar todo lead com esse padrão como quase fechado. O problema: historicamente, apenas 2% dos leads daquele canal viram clientes, e o sinal eleva a conversão para 6%, não para 60%.
O procedimento é montar uma tabela por canal: total de leads, leads com sinal, conversões com sinal, conversões sem sinal, ticket médio e tempo até oportunidade. Se há 1.000 leads e 100 têm o sinal, mas só 6 convertem, o score pode priorizar atendimento sem justificar forecast agressivo. Taxa-base não mata o insight; ela calibra o tamanho da aposta.
Alerta de churn em evento raro
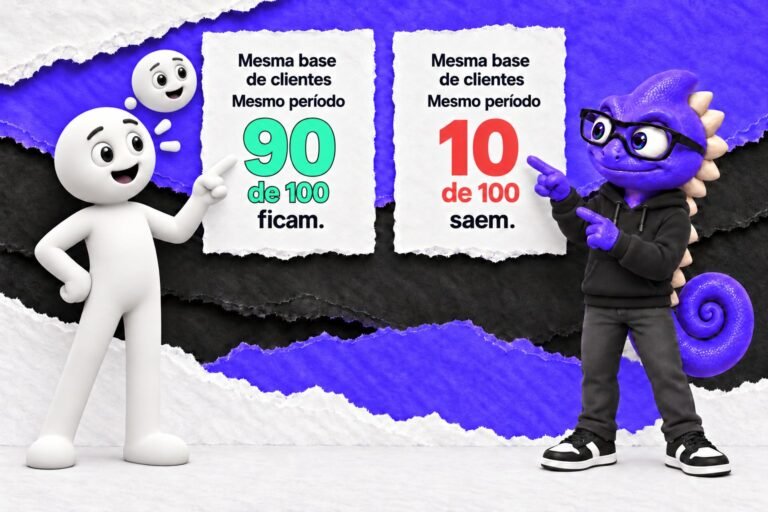
Outro cenário: uma ferramenta prevê “alto risco de cancelamento” para contas que reduziram uso por duas semanas. O alerta acerta parte dos churns, mas churn mensal grave ocorre em apenas 1% da base. Se o classificador dispara em 15% das contas, o time pode gastar desconto, CS e atenção em muitos falsos positivos.
Antes de automatizar retenção, estime prevalência por segmento, sensibilidade, falsos positivos, custo da intervenção e custo de perder a conta. Uma conta enterprise inativa há 30 dias e uma conta pequena em férias coletivas não têm a mesma taxa-base. O bom uso do alerta combina score com classe de referência.
Indicadores e explicações alternativas
Indicadores do erro são frases como “tem cara de comprador”, “o algoritmo marcou, então é provável” ou “esse perfil sempre cancela” sem denominador. Outro sinal é usar taxa média global quando o evento varia muito por canal, plano, maturidade, origem ou temporada.
Explicações alternativas também precisam entrar. Às vezes a taxa-base mudou por crise econômica, alteração de tracking, nova política comercial, mudança de mix de aquisição ou melhoria real do produto. Em outros casos, a informação específica é causalmente forte e merece grande peso. O erro não é usar sinal individual; é ignorar a frequência de fundo e a qualidade preditiva do sinal.
Como reduzir o risco
- Defina a população correta antes de calcular: canal, segmento, plano ou período.
- Converta porcentagens em frequências naturais.
- Separe verdadeiro positivo, falso positivo, verdadeiro negativo e falso negativo.
- Compare o sinal com uma linha de base sem o sinal.
- Calcule custo de ação e custo de omissão.
- Recalibre quando o mix de aquisição ou produto mudar.
Em uma reunião, a pergunta mais útil é: “entre todos os casos com esse sinal, quantos de fato tiveram o desfecho?”. Essa pergunta reduz o encanto de descrições vívidas e força a equipe a enxergar proporção, não só plausibilidade narrativa.
Limites científicos e conceitos próximos
As fontes primárias clássicas sustentam o erro de julgamento, mas não autorizam aplicar um número universal de correção. O efeito varia com formato da informação, contexto, expertise e desenho da tarefa. Em martech, as aplicações deste artigo são inferências operacionais: os estudos não mediram especificamente funis, CRMs ou plataformas de automação.
Conceitos próximos ajudam a delimitar. Insensibilidade ao tamanho da amostra trata da confiança exagerada em amostras pequenas. Negligência de probabilidade envolve baixa atenção ao tamanho da chance. Falácia da evidência anedótica troca dados por casos marcantes. Estereotipagem pode fornecer descrições que parecem representativas, mas não substituem taxa-base.