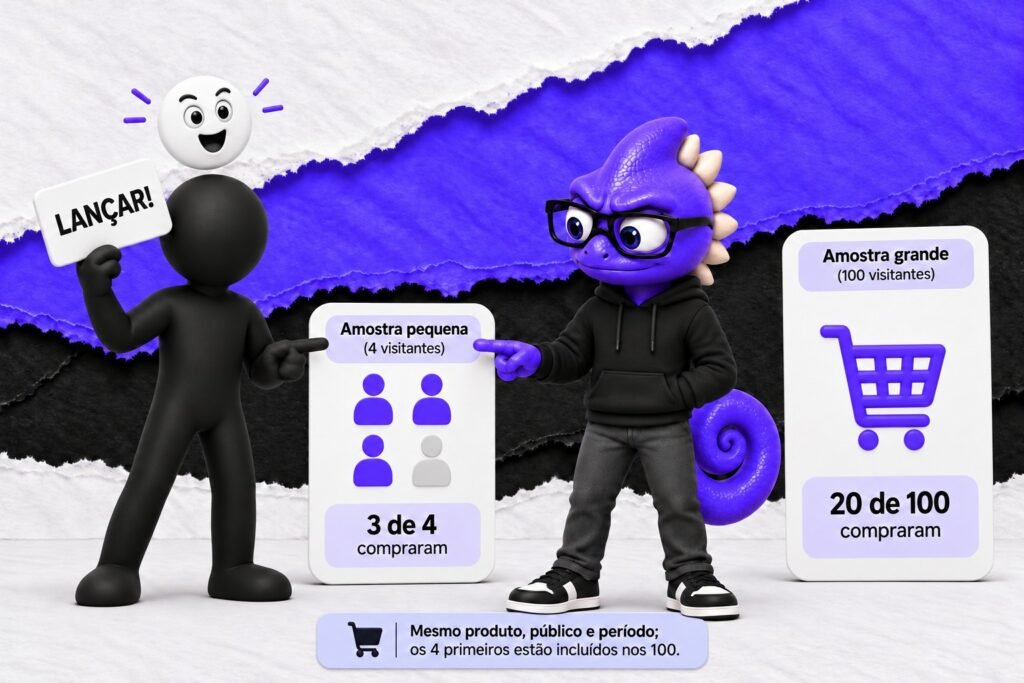
Insensibilidade ao tamanho da amostra é tratar um conjunto pequeno de observações como se ele tivesse a estabilidade de um conjunto grande. A pessoa vê uma taxa, uma proporção ou uma sequência e esquece que, com poucos casos, resultados extremos são mais comuns. Cinco respostas positivas em sete entrevistas podem parecer validação robusta; em uma amostra maior, a estimativa talvez recue bastante. O erro não está em olhar poucos casos, mas em dar a eles peso de estimativa populacional.
Mecanismo
Tversky e Kahneman chamaram esse padrão de crença na lei dos pequenos números: a expectativa de que pequenas amostras se pareçam muito com a população de onde vieram. O artigo de 1971 discutia inclusive decisões de pesquisa, mostrando que profissionais podiam superestimar o poder informativo de amostras pequenas. Em 1974, ao descrever heurísticas e vieses sob incerteza, os autores ligaram o problema à representatividade: quando um resultado parece típico ou coerente, a mente pergunta pouco sobre quantos casos o produziram.
No cotidiano, imagine escolher um restaurante porque três avaliações recentes deram cinco estrelas. Pode ser um ótimo sinal, mas também pode ser coincidência, seleção de clientes entusiasmados ou avaliação de amigos do dono. Com trezentas avaliações, a média ainda pode ser enviesada, mas a oscilação aleatória de cada avaliação individual pesa menos. Tamanho da amostra não resolve todos os problemas de qualidade, porém muda a variabilidade esperada.
Exemplos em martech
Primeiro exemplo: um teste A/B de landing page roda por dois dias. A versão B gera 4 compras em 80 visitas; a versão A gera 1 compra em 75 visitas. A taxa aparente de B é quase quatro vezes maior, e a equipe quer trocar a página. A insensibilidade aparece porque a conclusão ignora que são apenas cinco compras no total.
Antes de declarar vitória, a equipe deveria olhar volume mínimo, intervalo de incerteza, origem do tráfego, distribuição por dispositivo e se houve campanha ou e-mail específico em um dos dias. O resultado pode virar hipótese para continuar o teste, não decisão final.
Segundo exemplo: um SaaS segmenta churn por setor e percebe que “agências pequenas” tiveram 30% de cancelamento no mês. Parece um segmento problemático, até descobrir que eram três cancelamentos em dez contas. Talvez haja risco real, mas a taxa mensal é instável. O procedimento correto é agregar janelas maiores, comparar com coortes semelhantes, olhar motivos qualitativos e separar cancelamento voluntário, falha de pagamento e migração de plano. O indicador útil pode ser “sinal amarelo para investigação”, não “segmento ruim”.
Indicadores e alternativas
Indicadores do viés: decisões com poucos eventos absolutos, rankings de segmentos minúsculos, manchetes baseadas em percentuais sem denominador e surpresa excessiva com resultados extremos em grupos pequenos. Explicações alternativas também importam. Uma amostra pequena pode estar correta se o efeito for enorme, se o evento for raro mas crítico, ou se os casos forem escolhidos por relevância diagnóstica. O problema não é “n pequeno” por si só; é confundir exploração, alerta ou evidência qualitativa com estimativa estável.
Procedimento aplicável
Antes de concluir, escreva sempre numerador e denominador: “4 de 80”, não apenas “5%”. Depois classifique a decisão: exploratória, operacional reversível ou estratégica difícil de desfazer. Para decisões estratégicas, exija janela temporal e volume mínimo definidos antes de olhar o resultado. Para marketing, uma regra prática é registrar: unidade analisada, período, número de usuários expostos, número de conversões, variação esperada por acaso e condição de parada do teste. Se a condição de parada muda quando aparece um resultado conveniente, o processo está vulnerável.
Como ler percentuais sem cair no atalho
O antídoto mais direto é obrigar todo percentual a carregar seu denominador. “Conversão subiu de 1% para 4%” soa forte; “subiu de 1 compra em 100 visitas para 4 compras em 100 visitas” ainda pode ser relevante, mas lembra que quatro eventos definem a conclusão. Em relatórios executivos, uma tabela simples com eventos, base exposta e intervalo esperado já reduz muito o risco. Quando não há maturidade estatística para calcular intervalo formal, ao menos classifique a evidência como fraca, moderada ou forte conforme volume absoluto e custo da decisão.
Também vale diferenciar amostra pequena de segmento pequeno. Um segmento pode ser estrategicamente importante mesmo com poucos casos, como contas enterprise em um funil B2B. Nessa situação, o erro não é olhar o segmento; é fingir que sua taxa mensal estima uma população ampla. Para contas grandes, uma análise caso a caso pode ser superior a uma taxa agregada. Para e-commerce de alto volume, o inverso costuma valer: percentuais por microsegmento só devem virar decisão depois de acumular observações suficientes ou serem combinados com segmentos vizinhos por hipótese clara.
Um sinal de maturidade analítica é tratar resultados pequenos como convite a desenhar a próxima coleta. Se uma variação nova teve duas vendas a mais, a pergunta não é “ganhou ou perdeu?”, mas “quanto precisamos observar para distinguir efeito real de oscilação?”. Esse deslocamento reduz decisões impulsivas e preserva aprendizados iniciais sem vender certeza falsa.
Limites
Taxonomicamente, este fenômeno é um viés de julgamento probabilístico ligado à representatividade, não uma falácia lógica formal. Ele se relaciona à falácia do apostador e à ilusão de agrupamento, mas não é idêntico: aqui o foco é o peso indevido dado a poucos casos; na falácia do apostador, a pessoa espera compensação em eventos independentes; na ilusão de agrupamento, enxerga padrão em ruído. A correção não é adorar amostras grandes sem crítica. Amostras grandes podem ser enviesadas por coleta ruim, população errada ou métrica fraudada. O tamanho reduz incerteza aleatória; não garante validade.