
O que é BLEU?
BLEU, sigla de bilingual evaluation understudy, é uma métrica automática que mede o quanto um texto gerado por máquina se parece com um ou mais textos de referência escritos por pessoas. Ela conta sequências de palavras em comum, os n-gramas, e responde a uma pergunta de precisão: do que o modelo escreveu, quanto aparece na referência?
A métrica foi proposta por Kishore Papineni e colegas da IBM em 2002, no encontro anual da ACL, para avaliar tradução automática sem esperar semanas por avaliadores humanos. No artigo, a correlação com a nota dada por pessoas foi de 0,99 (avaliadores monolíngues) e 0,96 (bilíngues), em cinco sistemas. Hoje ela aparece também na avaliação de textos de LLM e em comparativos de benchmark de IA.
Exemplos Práticos de BLEU
Como o cálculo funciona:
- Precisão modificada de n-gramas: para n de 1 a 4, divide os n-gramas do candidato que aparecem na referência pelo total de n-gramas do candidato, contando cada um no máximo tantas vezes quantas aparece na referência.
- Média geométrica: as quatro precisões são combinadas com pesos iguais. Se uma delas for zero, o resultado inteiro vira zero.
- Penalidade de brevidade (BP): com c palavras no candidato e r na referência, BP = 1 quando c > r e BP = e^(1 − r/c) quando c ≤ r. O BLEU final é BP × média geométrica, entre 0 e 1.
Exemplo com números:
Referência: “a entrega chegou no prazo e o produto veio bem embalado” (11 palavras). Candidato gerado pela IA: “a entrega chegou no prazo e o produto veio intacto” (10 palavras). Calculei em Python, separando palavras por espaço:
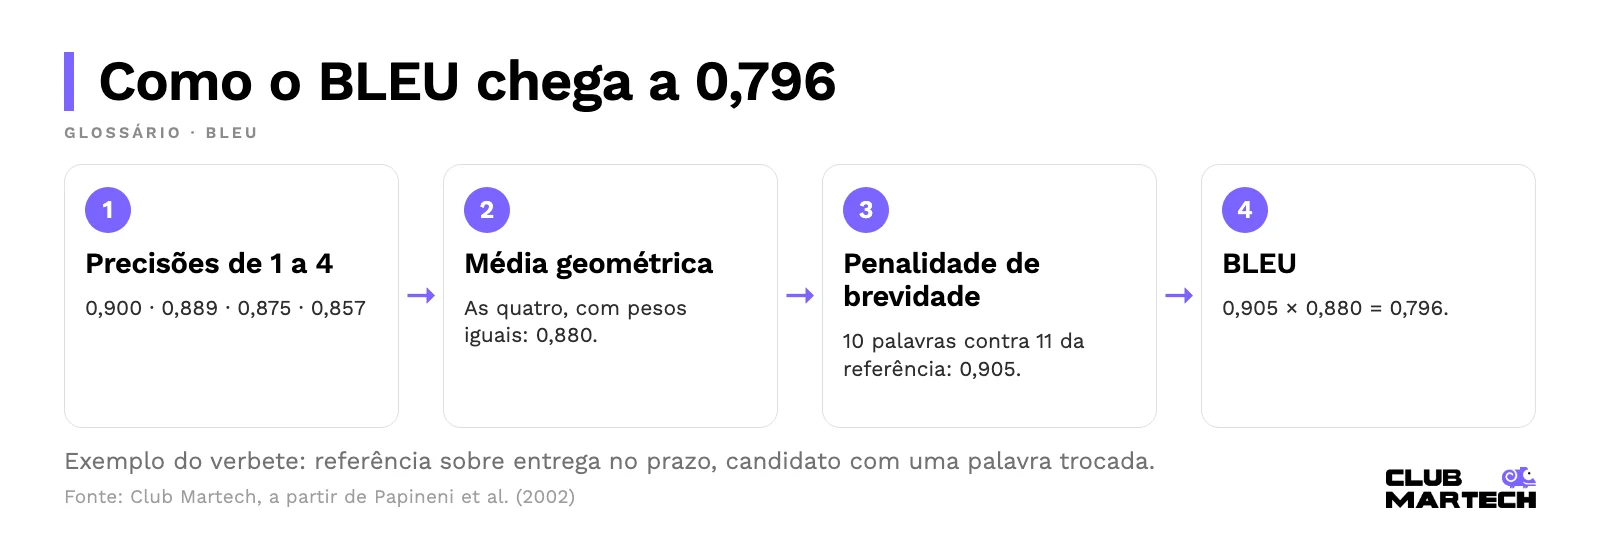
- Unigramas: 9 de 10 estão na referência (só “intacto” fica de fora), precisão de 0,900.
- Bigramas: 8 de 9 (0,889). Trigramas: 7 de 8 (0,875). 4-gramas: 6 de 7 (0,857).
- Média geométrica das quatro: 0,880.
- O candidato é mais curto (10 contra 11), então BP = e^(1 − 11/10) ≈ 0,905.
- BLEU ≈ 0,905 × 0,880 ≈ 0,796.
Agora encurte o candidato para “a entrega chegou no prazo”. As quatro precisões dão 1, porque cada pedaço existe na referência, mas a penalidade cai para e^(1 − 11/5) ≈ 0,301, e o BLEU fica em 0,301. A penalidade impede que uma resposta curta leve nota alta.
Sinônimos e Antônimos Relevantes
Sinônimos:
- BLEU score
- Pontuação BLEU
Antônimos:
- Avaliação humana de qualidade
- Métricas orientadas a recall, como o ROUGE
Contexto e Áreas de Aplicação
- Tradução automática: o uso original; o artigo de 2002 testou traduções do chinês para o inglês.
- Resumo: os autores sugeriram adaptar o BLEU para resumo; a métrica criada para isso é o ROUGE.
- Perguntas e respostas: compara a resposta do modelo com uma resposta-gabarito.
- IA no marketing: dá para comparar e-mails, descrições de produto ou resumos de atendimento gerados por IA com versões aprovadas pelo time, como sinal rápido de desvio do padrão. Veja onde esse texto entra no artigo sobre Natural Language Generation em campanhas.
Referências e Termos Relacionados
- ROUGE: pacote de métricas para resumo, orientado a recall.
- METEOR: criado para corrigir pontos fracos do BLEU, com alinhamento palavra a palavra e peso no recall.
- BERTScore: compara os textos por similaridade de embeddings contextuais, em vez de palavras idênticas.
- Perplexidade: mede a surpresa do modelo com um texto, sem referência.
- Métricas de avaliação de LLM: o conjunto de réguas em que o BLEU entra.
Notas Adicionais
- Feito para conjunto, não para frase: segundo o artigo, o BLEU só precisa acompanhar o julgamento humano na média de um conjunto de teste; a nota de uma frase isolada pode divergir. Mais referências elevam a nota: um tradutor humano marcou 0,3468 contra quatro referências e 0,2571 contra duas.
- Não mede fato, tom nem utilidade: um e-mail com preço errado pode pontuar alto se repetir as palavras da referência, então a métrica não pega alucinação. E a paráfrase “o pedido foi entregue dentro do prazo e chegou bem embalado”, que diz quase o mesmo que a referência do exemplo, tem BLEU zero: nenhum trigrama coincide.
- Português e tokenização: o artigo original só ignorava maiúsculas. Contrações como “no” e “do”, hífens e flexões mudam a contagem de tokens e n-gramas. Na minha leitura, use a mesma tokenização em todas as versões comparadas.
- Quando preferir outra métrica: se a mensagem pode ser dita de várias formas, use BERTScore, avaliação humana ou um LLM como juiz. Zheng et al. (2023) mediram concordância acima de 80% entre o GPT-4 e pessoas, com vieses de posição e de prolixidade.
Ilustrações e Visualizações
BLEU x ROUGE x METEOR
| Aspecto | BLEU | ROUGE | METEOR |
|---|---|---|---|
| Origem | Papineni et al., 2002, tradução | Lin, 2004, resumo | Banerjee e Lavie, 2005, tradução |
| Base do cálculo | Precisão de n-gramas | Recall de n-gramas e subsequências | Precisão e recall de palavras, com peso no recall |
| Ordem das palavras | Indireta, por n-gramas maiores | ROUGE-L, pela maior subsequência comum | Penalidade de fragmentação |
| Palavras diferentes com o mesmo sentido | Não reconhece | Não reconhece | Radical e sinônimos do WordNet, em inglês |
Classificação Gramatical
- Classe: substantivo (sigla)
- Gênero: masculino (o BLEU)
Pronúncia
- Leitura: o artigo original não indica pronúncia, e não há forma oficial em português.
Etimologia
- Origem: sigla de bilingual evaluation understudy, conforme nota de rodapé do artigo de 2002.
- Sentido: understudy é o ator substituto. Os autores apresentam o método como substituto automático de avaliadores humanos quando a avaliação precisa ser rápida ou frequente.