
O que é METEOR?
METEOR, sigla de Metric for Evaluation of Translation with Explicit ORdering, é uma métrica automática que compara um texto gerado por máquina com uma referência alinhando palavra a palavra, por forma idêntica, radical ou sinônimo. A nota combina precisão e recall, com mais peso no recall, e desconta uma penalidade quando as palavras alinhadas aparecem picotadas ou fora de ordem.
A métrica foi publicada em 2005 por Satanjeev Banerjee e Alon Lavie, da Carnegie Mellon, para corrigir pontos fracos que eles apontam no BLEU, como a falta de recall e a média geométrica que zera a nota de muitas frases. Com traduções do chinês para o inglês, a correlação com a avaliação humana por sistema foi de 0,964 para o METEOR e de 0,817 para o BLEU.
Exemplos Práticos de METEOR
Como o cálculo funciona:
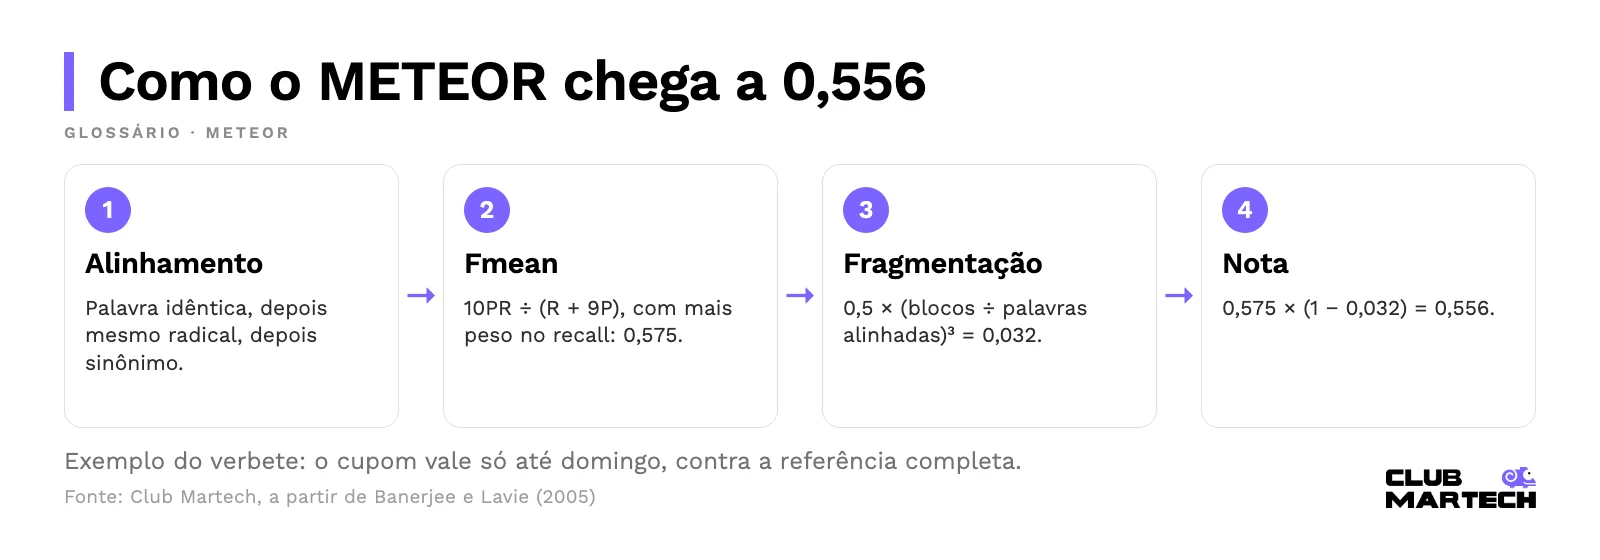
- Alinhamento: em etapas, liga palavras do candidato às da referência: idênticas, depois de mesmo radical (radicalizador de Porter), depois sinônimos do WordNet. Cada palavra se liga a no máximo uma; no empate, vence o alinhamento com menos cruzamentos.
- Fmean: P = alinhadas ÷ palavras do candidato; R = alinhadas ÷ palavras da referência; Fmean = 10PR / (R + 9P). É uma média harmônica que, nas palavras dos autores, põe a maior parte do peso no recall.
- Penalidade de fragmentação: agrupa as alinhadas no menor número de blocos (chunks) contíguos nos dois textos. Penalidade = 0,5 × (blocos ÷ unigramas alinhados)³. Nota = Fmean × (1 − penalidade), um corte de no máximo 50%.
Exemplo com números:
Referência (9 palavras): “o cupom vale para toda a loja até domingo”. Candidato gerado pela IA (6 palavras): “o cupom vale só até domingo”. Calculei em Python, só com correspondência exata:
- Palavras alinhadas: 5 (o, cupom, vale, até, domingo). P = 5/6 ≈ 0,833; R = 5/9 ≈ 0,556.
- Fmean = 10 × 0,833 × 0,556 ÷ (0,556 + 9 × 0,833) ≈ 0,575. O F1 comum daria 0,667; o METEOR puxa a nota para perto do recall.
- Blocos: “o cupom vale” e “até domingo”, ou seja, 2. Penalidade = 0,5 × (2/5)³ = 0,032.
- METEOR ≈ 0,575 × (1 − 0,032) ≈ 0,556.
Com a frase completa reordenada, “até domingo o cupom vale para toda a loja”, as 9 palavras alinham em 2 blocos e a nota vai a 0,995. O BLEU dessa frase fica em 0,803, porque a emenda quebra 4-gramas; o do primeiro candidato dá zero.
Sinônimos e Antônimos Relevantes
Sinônimos:
- METEOR score
- Pontuação METEOR
Antônimos:
- Métricas de correspondência exata, como o BLEU
- Avaliação humana de adequação e fluência
Contexto e Áreas de Aplicação
- Tradução automática: o uso original. O artigo usou dados árabe-inglês e chinês-inglês da DARPA/TIDES 2003, sempre com saída em inglês.
- Avaliação frase a frase: o foco do artigo foi a correlação por segmento: 0,347 em árabe e 0,331 em chinês.
- IA no marketing: e-mails, descrições de produto e resumos de atendimento, comparados a versões aprovadas pelo time, quando a mesma informação pode vir em outra ordem. Contexto no artigo sobre Natural Language Generation em campanhas.
Referências e Termos Relacionados
- BLEU: métrica de tradução por precisão de n-gramas, ponto de partida das críticas do METEOR.
- ROUGE: pacote de métricas para resumo, orientado a recall.
- WordNet: base lexical em inglês usada para os sinônimos.
- BERTScore: troca a lista de sinônimos por similaridade de embeddings contextuais.
- Métricas de avaliação de LLM: o conjunto de réguas em que o METEOR entra.
Notas Adicionais
- O peso fica no recall: há tutoriais que leem 10PR / (R + 9P) como favorecendo a precisão; é o contrário, e no artigo o recall sozinho já acompanhava melhor o julgamento humano. Outro erro é dividir os blocos pelo total de palavras do candidato: o denominador são os unigramas alinhados. No exemplo, dividir por 6 daria 0,019 em vez de 0,032.
- Português pede atenção: os módulos originais de radical e sinônimo são de inglês. Sem equivalentes em português, sobra a correspondência exata, e “chegou” e “chegaram” viram palavras diferentes. Na minha leitura, confirme o que a implementação oferece para a língua antes de comparar notas.
- Não mede fato, tom nem utilidade: o artigo do BERTScore (Zhang et al., 2020) mostra que, para a referência “people like foreign cars”, BLEU e METEOR dão nota maior a “people like visiting places abroad” do que a “consumers prefer imported cars”. Número inventado também pode pontuar bem: a métrica não pega alucinação.
- Quando preferir outra métrica: BERTScore para paráfrase; avaliação humana ou LLM como juiz para tom e utilidade, atento aos vieses de posição e de prolixidade que Zheng et al. (2023) mediram nesses juízes.
Ilustrações e Visualizações
METEOR x BLEU no exemplo do cupom
| Aspecto | BLEU | METEOR |
|---|---|---|
| Ordem | Indireta, pelos n-gramas maiores | Penalidade de fragmentação |
| Candidato “o cupom vale só até domingo” | 0 (nenhum 4-grama em comum) | 0,556 |
| Candidato reordenado completo | 0,803 | 0,995 |
Classificação Gramatical
- Classe: substantivo (sigla)
- Gênero: masculino (o METEOR)
Pronúncia
- Leitura: o artigo original não indica pronúncia, e não há forma oficial em português.
Etimologia
- Origem: sigla de Metric for Evaluation of Translation with Explicit ORdering, conforme nota do artigo de Banerjee e Lavie (2005).
- Sentido: o “explicit ordering” do nome se refere à penalidade de fragmentação, que mede a ordem das palavras de forma direta, em vez de deixá-la para os n-gramas maiores, como faz o BLEU.