
O que é ROUGE?
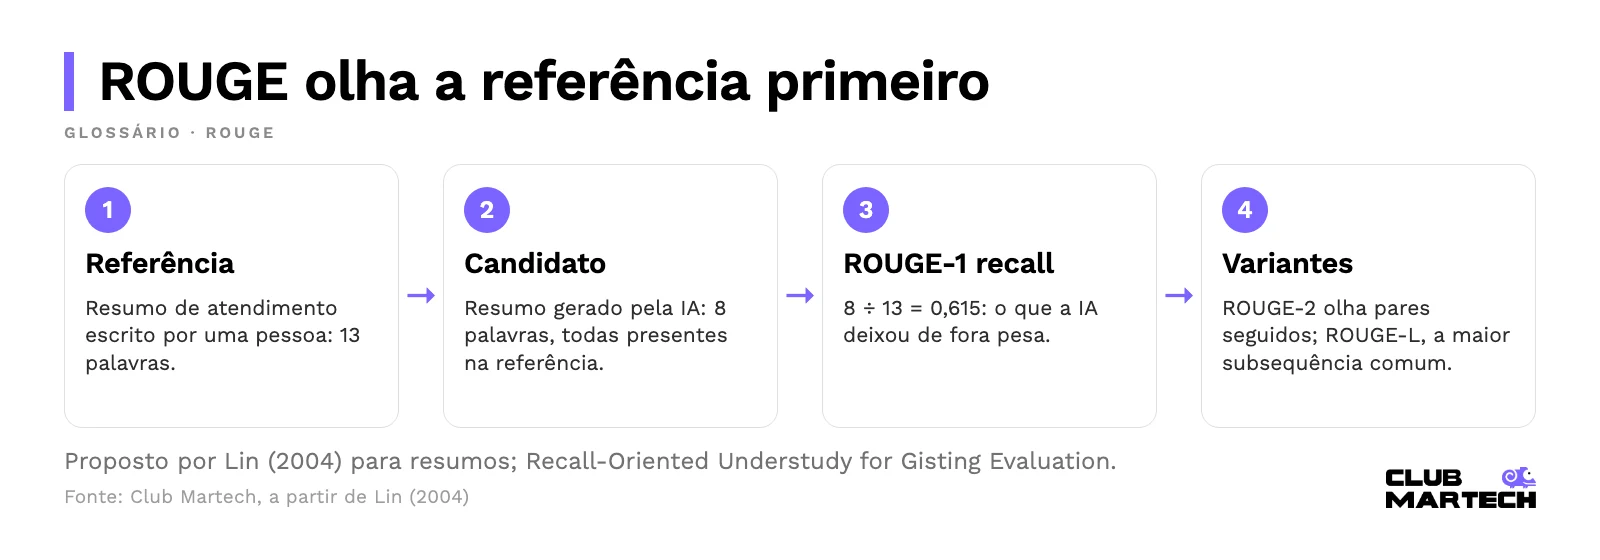
ROUGE, sigla de Recall-Oriented Understudy for Gisting Evaluation, é um pacote de métricas que compara um resumo gerado por máquina com resumos de referência escritos por pessoas, contando unidades em comum: n-gramas, sequências de palavras e pares de palavras. O foco está no nome: o recall, ou seja, quanto do conteúdo da referência aparece no texto gerado.
O pacote foi apresentado por Chin-Yew Lin, da Universidade do Sul da Califórnia, em 2004. O artigo cita o sucesso do BLEU na tradução como motivação, mas o ROUGE foi proposto separadamente e segue outra lógica: o BLEU parte da precisão, e o ROUGE-N, do recall.
Exemplos Práticos de ROUGE
As variantes:
- ROUGE-N: n-gramas em comum divididos pelo total de n-gramas da referência. O ROUGE-1 olha palavras soltas; o ROUGE-2, pares de palavras seguidas.
- ROUGE-L: usa a maior subsequência comum (LCS), palavras na mesma ordem mesmo que não estejam coladas. Combina recall (LCS ÷ tamanho da referência) e precisão (LCS ÷ tamanho do candidato) numa medida F.
- ROUGE-W e ROUGE-S: o primeiro dá mais crédito a trechos contínuos; o segundo conta pares de palavras na ordem certa, mesmo com outras palavras no meio.
Exemplo com números:
Referência de um resumo de atendimento (13 palavras): “cliente pediu reembolso porque o produto chegou quebrado e quer resposta até sexta”. Resumo gerado pela IA (8 palavras): “cliente quer reembolso porque o produto chegou quebrado”. Calculei em Python, separando as palavras por espaço:
- ROUGE-1: as 8 palavras do candidato estão na referência. Recall = 8/13 ≈ 0,615; precisão = 8/8 = 1; F1 ≈ 0,762.
- ROUGE-2: 5 bigramas em comum (“reembolso porque”, “porque o”, “o produto”, “produto chegou”, “chegou quebrado”). Recall = 5/12 ≈ 0,417; precisão = 5/7 ≈ 0,714; F1 ≈ 0,526.
- ROUGE-L: a maior subsequência comum tem 7 palavras, “cliente reembolso porque o produto chegou quebrado”; “quer” existe na referência, mas fora dessa ordem. Recall = 7/13 ≈ 0,538; precisão = 7/8 = 0,875; F1 ≈ 0,667.
A precisão alta diz que o resumo não inventou palavras. O recall baixo mostra o que ficou de fora: o prazo até sexta, justamente o dado de que o próximo atendente precisaria.
Sinônimos e Antônimos Relevantes
Sinônimos:
- ROUGE score
- Pontuação ROUGE
Antônimos:
- Métricas orientadas a precisão, como o BLEU
- Avaliação humana de cobertura de conteúdo
Contexto e Áreas de Aplicação
- Resumo automático: o uso original, testado com dados das DUC de 2001, 2002 e 2003.
- Tradução automática: o artigo cita um estudo separado (Lin e Och, 2004) em que ROUGE-L, ROUGE-W e ROUGE-S também funcionaram bem para tradução.
- Perguntas e respostas: mede quanto da resposta-gabarito o modelo cobriu. Em sistemas de RAG, na minha leitura, serve como checagem inicial de cobertura, sem dizer se a resposta está certa.
- IA no marketing: resumos de atendimento, de reunião ou de pesquisa com cliente comparados a um resumo escrito por quem conhece o caso; descrições de produto comparadas à ficha aprovada.
Referências e Termos Relacionados
- BLEU: métrica de tradução baseada em precisão de n-gramas, com penalidade de brevidade.
- METEOR: alinha palavra a palavra, aceita radicais e sinônimos e pune a fragmentação.
- LCS (longest common subsequence): a maior sequência de palavras que aparece, na mesma ordem, nos dois textos.
- BERTScore: compara os textos por similaridade de embeddings contextuais.
- Métricas de avaliação de LLM: o conjunto de réguas em que o ROUGE entra.
Notas Adicionais
- Nome e leitura do número: a grafia é ROUGE; “ROGUE” aparece por engano em alguns tutoriais. Na DUC, o parâmetro da medida F era tão alto que só o recall contava. Muitas bibliotecas atuais mostram precisão, recall e F1 lado a lado, então confira qual dos três o relatório traz.
- Não mede fato, tom nem utilidade: o candidato “cliente não pediu reembolso porque o produto chegou quebrado”, que inverte o sentido, tem ROUGE-L F1 de 0,727 contra a mesma referência. A paráfrase fiel “cliente solicitou estorno porque a mercadoria veio danificada e aguarda retorno até sexta” fica em 0,385. A métrica conta palavras repetidas e não detecta alucinação.
- Depende da referência e da língua: no artigo, a correlação com avaliadores humanos ficou alta em resumos de um documento e raramente chegou a 0,90 em resumos de vários documentos, salvo os longos. Os testes usaram o radicalizador de Porter, feito para inglês. Em português, contrações, acentos e flexões mudam a contagem; use a mesma tokenização em todos os textos comparados.
- Quando preferir outra métrica: para paráfrase, BERTScore; para fato, tom e utilidade, avaliação humana ou um LLM como juiz, sabendo que Zheng et al. (2023) registraram vieses de posição e de prolixidade nesses juízes.
Ilustrações e Visualizações
ROUGE-1 x ROUGE-2 x ROUGE-L no exemplo do atendimento
| Variante | Unidade comparada | Considera a ordem? | Recall | F1 |
|---|---|---|---|---|
| ROUGE-1 | Palavras soltas | Não | 0,615 | 0,762 |
| ROUGE-2 | Pares de palavras seguidas | Só dentro do par | 0,417 | 0,526 |
| ROUGE-L | Maior subsequência comum | Sim, sem exigir palavras coladas | 0,538 | 0,667 |
Classificação Gramatical
- Classe: substantivo (sigla)
- Gênero: masculino (o ROUGE)
Pronúncia
- Leitura: o artigo original não indica pronúncia, e não há forma oficial em português.
Etimologia
- Origem: sigla de Recall-Oriented Understudy for Gisting Evaluation, conforme o artigo de Lin (2004).
- Sentido: gist é a ideia central de um texto, o que um resumo precisa capturar. Understudy, o ator substituto, é a mesma palavra que aparece na sigla do BLEU.