Métricas de avaliação de LLM são os números que dizem se um texto gerado por um modelo de linguagem está perto do que você queria. Algumas comparam palavras com um texto de referência, outras comparam significado, outras pedem a um segundo modelo que dê a nota. No fim, alguém da equipe ainda precisa aprovar.
Pense na correção de uma prova de vestibular em papel. A parte de múltipla escolha se corrige com gabarito: a máquina lê as bolinhas e soma os acertos em segundos. A redação não tem gabarito. Ela passa por corretores com uma grade de critérios, e quando dois discordam muito, entra um terceiro. As métricas de avaliação de LLM funcionam do mesmo jeito: umas são gabarito, rápidas e baratas, outras são corretor com grade, mais lentas e mais próximas do julgamento que importa.
A seguir, o que cada família mede, onde engana e um roteiro para o seu time montar a própria avaliação.
Por que o time de marketing precisa de métricas de avaliação de LLM
O time já usa IA para escrever assunto de e-mail, variação de anúncio, descrição de produto e resumo de atendimento. Um dia alguém troca o modelo ou ajusta o prompt, e ninguém sabe dizer se ficou melhor ou pior. A discussão vira gosto pessoal: “achei mais natural”, “achei mais genérico”.
Sem critério escrito, o texto com alucinação passa porque soa confiante, e a troca de fornecedor é decidida por demonstração de venda. Cada revisor aprova com uma régua diferente, o que impede comparar uma semana com a outra. Uma avaliação documentada também faz parte da governança de IA na empresa: ela registra o que foi testado antes de um texto automático chegar ao cliente.
O problema é antigo: em 2004, o artigo que apresentou o ROUGE estimava em mais de 3.000 horas de trabalho humano a avaliação manual de resumos da conferência DUC. As métricas automáticas nasceram para baratear essa conta.
BLEU, ROUGE e METEOR: métricas de avaliação de LLM que contam palavras
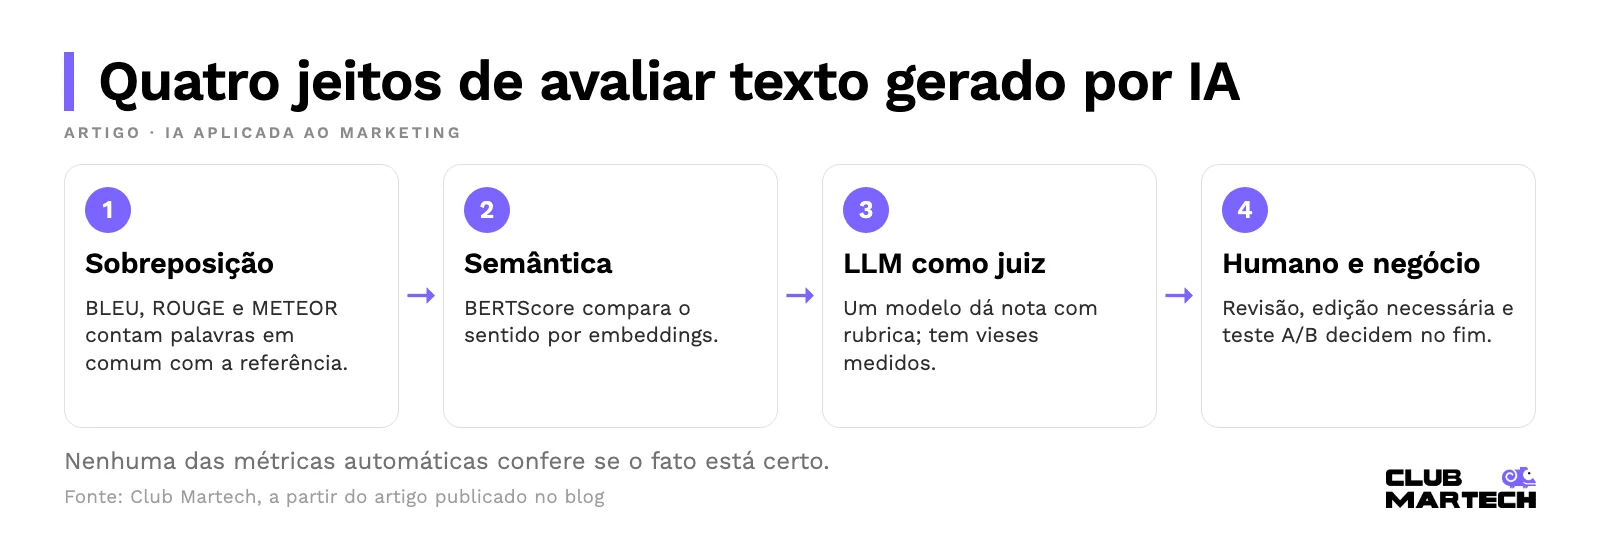
As três comparam o texto gerado (o candidato) com um ou mais textos de referência escritos por pessoas. Elas trabalham com n-gramas, que são sequências de n palavras seguidas.
- BLEU (Papineni et al., IBM, 2002) foi criado para tradução automática. Mede precisão: quanto do candidato aparece na referência, de palavras isoladas até sequências de quatro, combinadas por média geométrica. Como precisão sozinha premiaria respostas curtas, há uma penalidade de brevidade quando o candidato é menor que a referência.
- ROUGE (Chin-Yew Lin, 2004), sigla de Recall-Oriented Understudy for Gisting Evaluation, foi proposto para resumos. O ROUGE-N mede revocação (recall): quanto da referência aparece no candidato. O ROUGE-L usa a maior subsequência comum, as palavras que aparecem na mesma ordem nos dois textos, mesmo com outras no meio.
- METEOR (Banerjee e Lavie, 2005) alinha as palavras uma a uma e aceita, além da forma exata, o mesmo radical e sinônimos do WordNet. Combina precisão e recall pela fórmula 10PR/(R+9P), que põe a maior parte do peso no recall, e desconta até 50% quando as palavras coincidem soltas em vez de em blocos.
Fiz a conta com um assunto de e-mail de carrinho abandonado. Referência: “Seu carrinho ainda está esperando por você” (7 palavras). Candidato A: “Seu carrinho está esperando por você” (6 palavras). Candidato B: “Os produtos que você escolheu continuam reservados”. Cálculo simplificado, por frase, só com correspondência exata:
- Candidato A: as 6 palavras estão na referência, então a precisão é 6/6 = 1 e o recall (ROUGE-1) é 6/7 = 0,86. Coincidem 4 de 5 pares, 2 de 4 trios e 1 de 3 quádruplas; a média geométrica dá 0,60, a penalidade de brevidade é e^(1 − 7/6) = 0,85 e o BLEU fica em 0,51. No METEOR, há dois blocos (“Seu carrinho” e “está esperando por você”) e a nota fica em 0,85.
- Candidato B: só “você” coincide. Precisão e recall ficam em 1/7 = 0,14 e, como nenhum par de palavras se repete, o BLEU vai a zero.
O candidato B pode ser um bom assunto, mas as três métricas só medem coincidência de palavras com o texto escolhido como certo.
| Métrica | O que mede | Onde serve | Onde falha |
|---|---|---|---|
| BLEU (2002) | Precisão de n-gramas de 1 a 4 palavras, com penalidade para texto curto | Comparar versões de um sistema em muitas frases contra as mesmas referências, como tradução de catálogo | Paráfrase boa tira nota baixa; por frase, um zero em qualquer n-grama zera o resultado; muda com o número de referências |
| ROUGE (2004) | Recall de n-gramas (ROUGE-N) e maior subsequência comum (ROUGE-L) | Conferir se um resumo cobre o conteúdo dos resumos de referência, como resumo de atendimento | Depende de palavra idêntica; cobrir as palavras não garante que o resumo esteja correto |
| METEOR (2005) | Alinhamento com radical e sinônimos, peso maior no recall e penalidade de fragmentação | Avaliar frase a frase com alguma tolerância a variação de forma | Radical e sinônimos pensados para inglês; correlação com humanos bem menor por frase do que no agregado |
No artigo do METEOR, a correlação com notas humanas foi de 0,964 no nível do sistema (o agregado de todas as frases), contra 0,817 do BLEU, nos dados de chinês para inglês do TIDES 2003. Frase a frase, caiu para 0,331. E no artigo do BLEU um tradutor humano tirou 0,3468 contra quatro referências e 0,2571 contra duas. Na minha leitura, essas métricas de avaliação de LLM ajudam a comparar duas versões de prompt em centenas de textos e dizem pouco sobre um anúncio específico.
BERTScore e perplexidade: significado e previsibilidade
O BERTScore (Zhang et al., ICLR 2020) ataca o problema do candidato B. Em vez de exigir a mesma palavra, transforma cada token em um vetor contextual e compara os vetores por similaridade de cosseno. O exemplo dos autores: diante da referência “people like foreign cars”, BLEU e METEOR dão nota maior a “people like visiting places abroad” do que a “consumers prefer imported cars”, que diz o mesmo com outras palavras.
Com saídas de 363 sistemas de tradução e legenda de imagem, o BERTScore correlacionou melhor com julgamento humano do que as métricas anteriores. Os autores avisam que nenhuma configuração venceu todas e que a nota bruta fica numa faixa estreita, por isso propõem reescalonar. Um BERTScore isolado diz pouco: ele compara versões calculadas com a mesma configuração e continua precisando de referência.
A perplexidade é de outra natureza. Mede o quanto o próprio modelo fica “surpreso” com um texto: quanto menor, mais previsível. Não usa referência e não mede qualidade, já que um texto cheio de clichês pode ter perplexidade baixa. Serve para comparar modelos com protocolo idêntico, não para dar nota a um texto de campanha.
LLM como juiz: o que a pesquisa mostra e onde ele erra
Para texto aberto, como um post, raramente existe uma referência única. A alternativa é pedir a um modelo forte que avalie com uma rubrica ou escolha a melhor de duas respostas. O estudo de referência é de Zheng et al. (NeurIPS 2023), com o MT-Bench e o Chatbot Arena.
O GPT-4 como juiz concordou com especialistas em mais de 80% dos casos, o mesmo nível da concordância entre humanos. O detalhe está na tabela: contando só votos sem empate, na primeira rodada do MT-Bench, a concordância GPT-4 com humanos foi de 85% e a de humano com humano, 81%. Incluindo empates e votos inconsistentes, caem para 66% e 63%.
Os próprios autores apontam os vieses do juiz:
- Posição: com duas respostas parecidas, os juízes tendem a favorecer a primeira. Ao trocar a ordem, o GPT-4 manteve o veredito em 65% dos casos; o Claude-v1, em 23,8%.
- Verbosidade: com respostas infladas por uma lista repetida sem informação nova, GPT-3.5 e Claude-v1 preferiram a versão inchada em 91,3% de 23 casos; o GPT-4, em 8,7%.
- Autofavorecimento: o GPT-4 deu taxa de vitória 10% maior a si mesmo e o Claude-v1, 25%, mas os autores dizem que os dados não bastam para afirmar o viés.
- Raciocínio limitado: o juiz errou questões de matemática que sabia resolver sozinho, induzido pelas respostas avaliadas.
As correções do artigo são fáceis de copiar: rodar o juiz duas vezes trocando a ordem e só declarar vencedor quando ele concorda nas duas, e dar ao juiz uma resposta de referência. Em 10 questões de matemática avaliadas nas duas ordens, as falhas caíram de 14 em 20 para 3 em 20 com a referência. Os números são de modelos de 2023; na minha leitura, o que se transfere para hoje é o método de checagem.
Avaliação humana e métricas de negócio decidem no fim
Todas as métricas de avaliação de LLM acima se validam pelo mesmo critério: quanto concordam com pessoas. A avaliação humana funciona como a régua das outras. No marketing, ela vira números fáceis de registrar:
- Taxa de aprovação na revisão: de cada 100 textos gerados, quantos o revisor aprova sem mexer.
- Edição necessária: quanto do texto mudou antes de publicar, e por quê (fato errado, tom, tamanho, CTA).
- Resultado em teste A/B: CTR ou conversão do texto gerado contra o controle, com amostra dimensionada antes, por exemplo na calculadora de amostra e duração de teste A/B.
O resultado de negócio é a resposta final, mas chega tarde e custa tráfego. Métricas automáticas e juiz filtram rápido; a revisão humana aprova antes de o teste A/B dar a palavra final.
Benchmark de fornecedor: leia com a ressalva de quem fez
Lançamentos de modelo costumam vir com benchmark. Em 06/11/2026 a OpenAI divulgou o BioBasicsBench, sobre como agentes de IA lidam com tarefas cotidianas de laboratório de biologia. Segundo a empresa, são 100 tarefas e 18.500 resultados, com o GPT-6 Astra em 66,7% e o GPT-5.6 Sol em 43,8%. O teste foi desenvolvido pela OpenAI com a Ligo e não tem validação independente.
O número pode ser honesto e ainda dizer pouco sobre o seu caso: quem desenhou a prova também vende o modelo, e a tarefa medida raramente é a sua. O artigo sobre benchmark de agentes de IA mostra a melhor nota de um teste de uso de computador cair de 86% na versão 1 para 44,3% na versão mais recente. Por isso, vale ter o seu próprio conjunto de avaliação. Na reunião com o fornecedor, pergunte:
“Que métrica vocês usam para dizer que o texto gerado está bom, contra qual conjunto de referência ela foi calculada, e quanto essa métrica concorda com a avaliação de pessoas em textos parecidos com os do meu time?”
Um roteiro de avaliação para o time de marketing
Este processo põe cada uma das métricas de avaliação de LLM no papel certo e vale para qualquer uso de geração de linguagem natural em campanhas:
- Conjunto de referência: separe algumas dezenas de casos reais de uma tarefa, cada um com a entrada (produto, briefing, ticket) e o texto aprovado que foi ao ar. Esse conjunto fica fixo para comparar versões.
- Rubrica: de quatro a seis critérios com escala curta, como fato correto, tom da marca, CTA presente e tamanho dentro do limite. Fato errado reprova o texto, seja qual for o resto.
- Métrica automática: se a tarefa tem referência estável (resumo, tradução de catálogo), rode ROUGE ou BERTScore em todas as versões. Use para detectar queda, não para aprovar.
- Juiz mais humano: um LLM com a rubrica pontua tudo, trocando a ordem nas comparações. Uma pessoa avalia uma amostra às cegas, e você mede a concordância entre as duas notas antes de confiar no juiz.
- Registro: anote modelo, versão do prompt, data, notas e motivo de cada reprovação. Sem isso, a próxima troca de modelo volta a ser decidida por impressão.
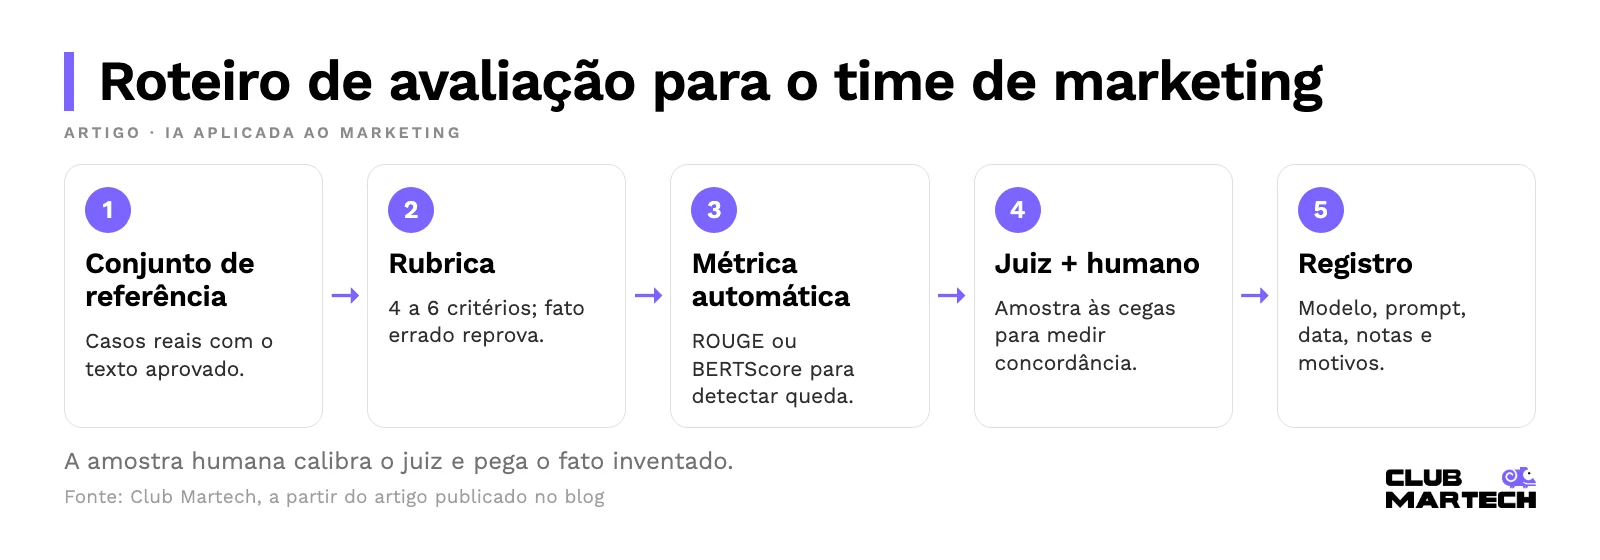
O limite é o custo da revisão humana, que não escala para todo texto. A amostra humana calibra o juiz e pega o erro que ele não vê, principalmente fato inventado.
Próximos passos para aplicar métricas de avaliação de LLM no seu time
Escolha hoje a tarefa de maior volume em que o time usa IA, provavelmente assunto de e-mail ou descrição de produto. Puxe 30 textos aprovados dessa tarefa e guarde a entrada que gerou cada um. Escreva uma rubrica de quatro critérios e peça a duas pessoas que avaliem, sem conversar, 10 textos gerados pela configuração atual. Se discordarem em boa parte das notas, o problema ainda é a rubrica, e nenhuma das métricas de avaliação de LLM resolve isso por você. Se concordarem, você tem a primeira régua do time e pode colocar o juiz automático para trabalhar ao lado delas.